Hard Negatives, Hard Lessons: Revisiting Training Data Quality for Robust Information Retrieval with LLMs
Hard Negatives, Hard Lessons: Revisiting Training Data Quality for Robust Information Retrieval with LLMs
Written By. Nandan Thakur, Crystina Zhang, Xueguang Ma, Jimmy Lin (University of Waterloo)
1. 문제 정의
- 학습 데이터는 많을수록 좋은가: 최근 retriever·reranker는 BGE collection(15개 데이터셋, 약 1.6M query-passage 쌍)처럼 여러 데이터셋을 섞은 대규모 학습 데이터를 사용함.
- 그러나 모든 데이터셋이 도움이 되는 것은 아님. 일부 데이터셋은 오히려 성능을 떨어뜨림.
- False negative 문제: MS MARCO, NQ처럼 질의당 정답이 1~2개만 라벨링된 sparse judgment 데이터에서는, 라벨링되지 않은 관련 문서가 hard negative로 뽑히는 경우가 많음.
- 실제로는 질의에 답하는 문서인데 negative로 학습되므로, 모델은 관련 문서를 밀어내도록 잘못 학습됨.
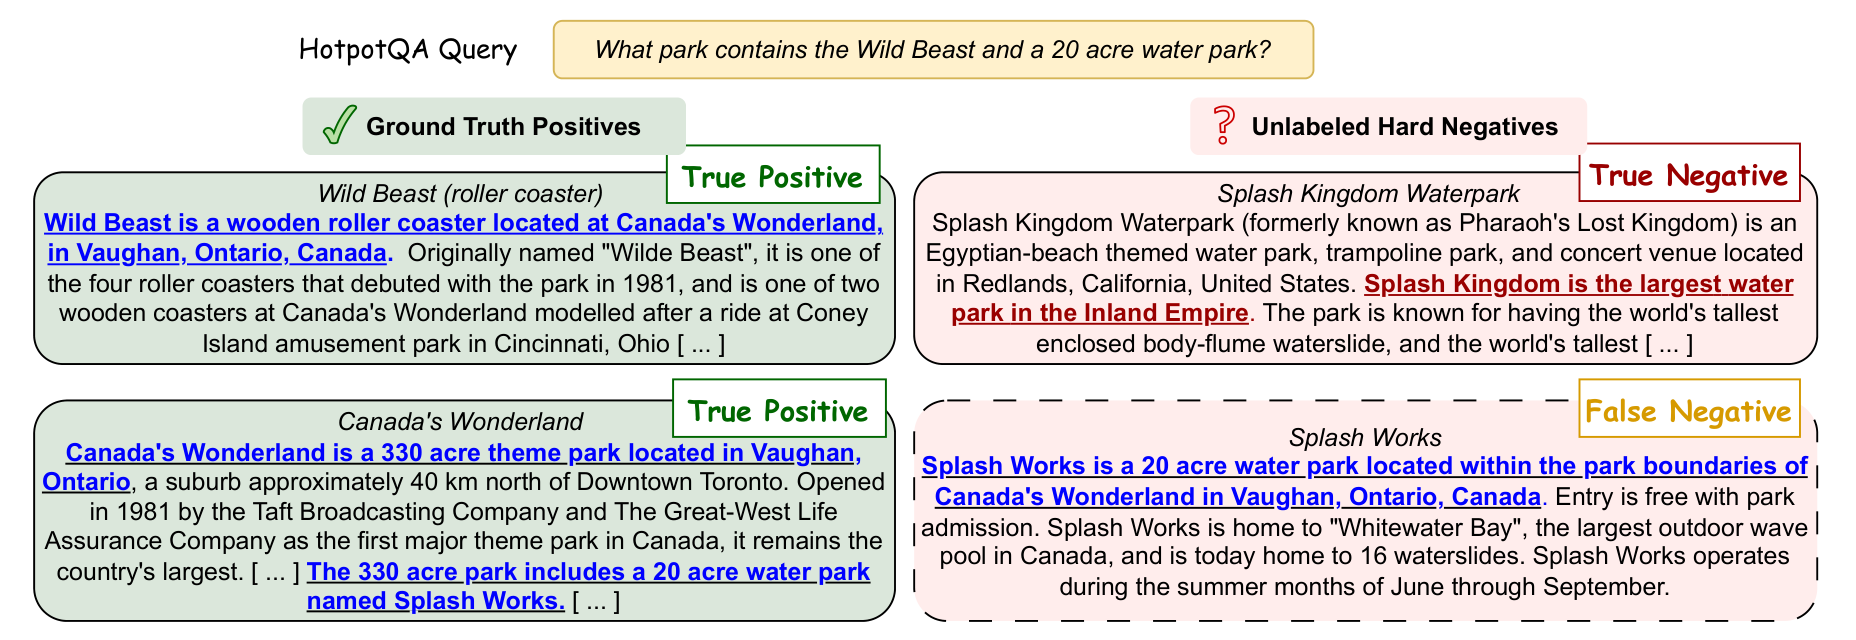
- 예시 (논문 Figure 1, HotpotQA): 정답 문서 외에, hard negative로 뽑힌 “Splash Works” 문서도 질의에 대한 답을 담고 있음.
- 핵심 질문: 학습 데이터 속 false negative를 저비용으로 정확히 찾아내고, 이를 어떻게 처리해야 retriever·reranker 성능이 가장 좋아지는가?
2. 해결 방법
A. 사전 실험: 데이터셋 Pruning
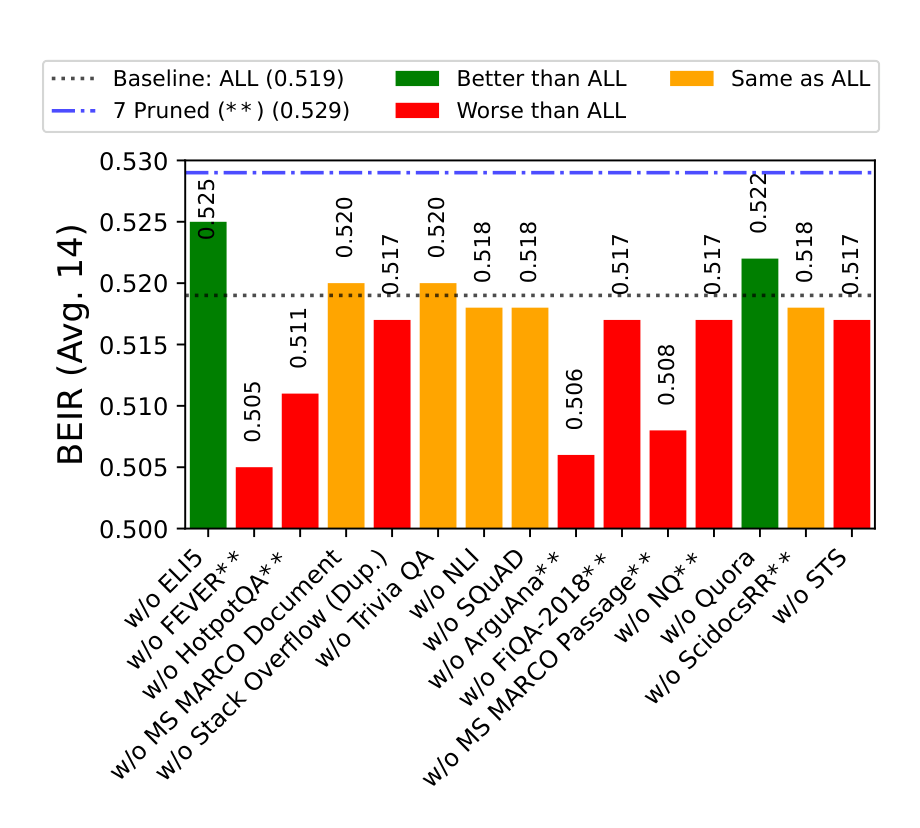
E5 (base)를 BGE collection으로 학습하면서, 데이터셋을 하나씩 빼고 학습하는 leave-one-dataset-out 실험을 수행함.- 빼도 성능이 유지되거나 오르는 데이터셋은 제거 대상으로 봄. 예를 들어 ELI5를 빼면 BEIR 14개 평균이 0.519 → 0.525로 오름.
- 반대로 FEVER(0.505), MS MARCO(0.508), ArguAna(0.506), HotpotQA(0.511)는 빼면 성능이 크게 떨어짐.
- 최종적으로 15개 중 8개를 제거하고 7개만 남김.
- 남긴 데이터셋: MS MARCO, HotpotQA, NQ, FEVER, SCIDOCSRR, FiQA-2018, ArguAna
- 학습 쌍이 약 1.6M → 680K 로 2.35배 줄었는데, BEIR 평균 nDCG@10은 0.519 → 0.529 로 오히려 1.0 상승함.
- 이후 실험은 모두 이 pruning된 7개 데이터셋(680K 쌍)을 기준으로 진행함.
B. RLHN: LLM Cascading Judge로 False Negative 탐지
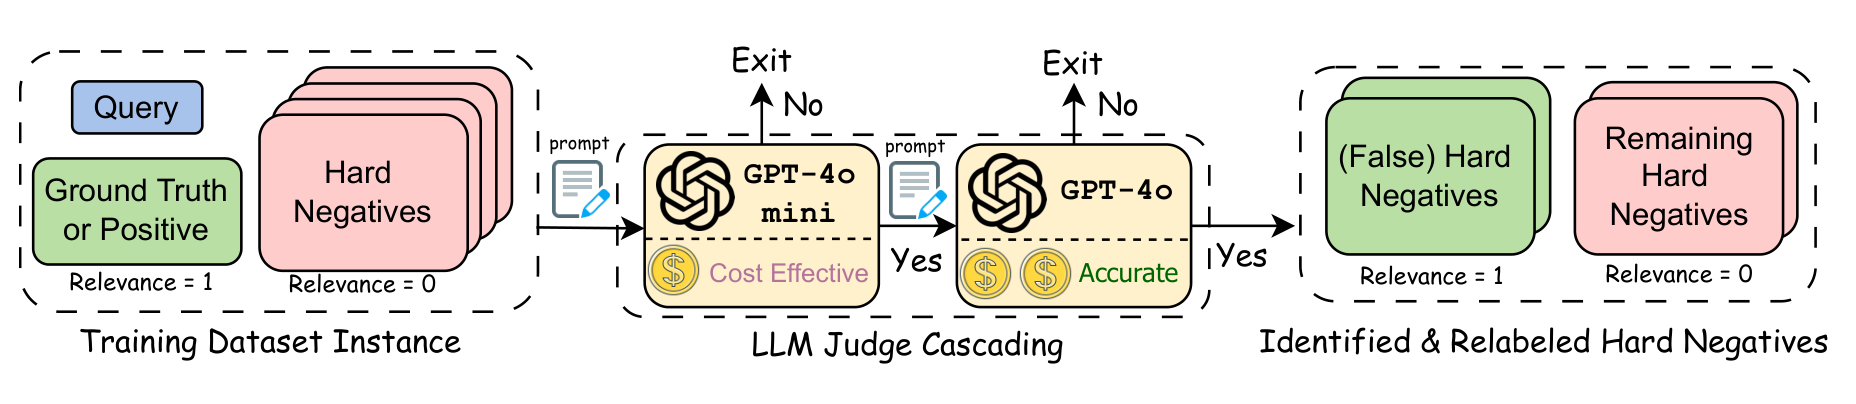
- 모든 학습 쌍을 비싼 LLM으로 검사하면 비용이 너무 크기 때문에, 저렴한 모델로 넓게 거르고 비싼 모델로 다시 확인하는 2단계 cascade 구조를 사용함.
① Stage 1: GPT-4o-mini로 1차 선별 (recall 확보)
- 질의, 정답 문서, hard negative 목록을 함께 주고 각 hard negative가 정답 문서와 비교해 질의에 답할 수 있는지 판단하게 함.
- CoT prompting, temperature 0.1, 한 번의 API 호출에 질의당 최대 25개 hard negative를 넣음.
- 출력은 hard negative를 태그로 분류함.
<better>: 정답 문서보다 낫거나 같은 수준으로 관련 있음<worse>: 관련은 있지만 정답 문서보다 부족함- 하나라도
<better>또는<worse>에 들어간 샘플은 Stage 2로 넘김.
프롬프트 요지 (논문 Figure 6 요약):
1
2
3
4
5
Given (1) a search question, (2) a relevant ground-truth document,
and (3) a set of unrelated documents,
evaluate whether any of the unrelated documents are relevant compared to the ground-truth document.
A document is only considered relevant to the question
if it provides sufficient information in answering the question.
② Stage 2: GPT-4o로 재검증 (precision 확보)
- Stage 1에서 걸러진 샘플만
GPT-4o로 다시 판단함. - 최종적으로
<better>태그에 들어간 hard negative를 false negative 로 확정함.
③ 탐지 결과
| 데이터셋 | 학습 쌍 | 질의당 정답 수 | 질의당 HN 수 | Stage 1 탐지 | Stage 2 탐지 |
|---|---|---|---|---|---|
| MS MARCO | 485,823 | 1.1 | 25.0 | 391,965 | 326,301 |
| HotpotQA | 84,516 | 2.0 | 20.0 | 11,268 | 4,756 |
| NQ | 58,568 | 1.0 | 98.5 | 32,184 | 19,199 |
| FEVER | 29,096 | 1.3 | 20.0 | 7,764 | 3,577 |
| SCIDOCSRR | 12,655 | 1.6 | 19.7 | 2,068 | 351 |
| FiQA-2018 | 5,500 | 2.6 | 15.0 | 3,632 | 1,833 |
| ArguAna | 4,065 | 1.0 | 13.6 | 0 | 0 |
- 탐지 수는 false negative가 1개 이상 포함된 학습 쌍의 수임.
- MS MARCO가 가장 심각함: 전체 탐지 쌍의 91.6%를 차지함. 가장 적은 SCIDOCSRR도 약 3% 수준으로 false negative가 존재함.
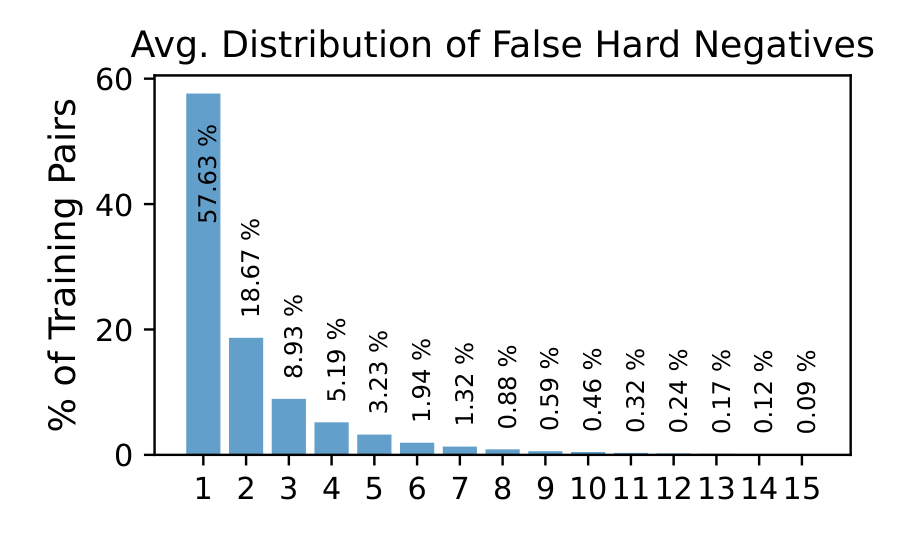
- 탐지된 쌍 중 57.63%는 false negative가 1개, 18.67%는 2개이며, 개수가 많아질수록 빠르게 줄어듦.
- ArguAna는 유사 문서가 아니라 반론 문서를 찾는 과제이므로 relabeling 대상에서 제외함.
④ 비용
- Stage 1 (
GPT-4o-mini): 약 300 USD - Stage 2 (
GPT-4o): 약 3,000 USD, 이 중 MS MARCO가 약 2,432 USD를 차지함. - Azure OpenAI batch API 기준으로 계산함.
C. 탐지된 False Negative 처리 방식
- 탐지 결과를 학습 데이터에 반영하는 3가지 방식을 비교함.
| 방식 | 처리 |
|---|---|
| Remove | false negative가 하나라도 있는 학습 샘플 전체를 삭제 |
| Remove HN | 해당 false negative만 hard negative 목록에서 삭제 |
| RLHN | false negative를 hard negative에서 빼서 정답(positive) 목록으로 옮김 |
- false negative가 7개를 초과하는 샘플은 질의 자체가 모호할 가능성이 높다고 보고 학습에서 제외함.
- 사람이 라벨링한 기존 정답의 오류, 즉 false positive는 검사하지 않음.
D. 학습 설정
- Retriever:
E5 (base)(110M, mean pooling),Qwen2.5-7B(7.6B, [EOS] pooling) - Reranker:
Qwen2.5-3B - 프레임워크는 Tevatron을 사용함.
- 질의당 positive 1개, hard negative 7개와 in-batch negative를 함께 사용해 InfoNCE로 학습함.
- 논문에 수식은 명시되어 있지 않아, 표준 InfoNCE 형태로 적음.
- learning rate 2e-5, 학습 최대 길이 350 토큰, 추론 512 토큰,
query:/passage:prefix 사용.
3. 실험
- 평가 벤치마크:
- BEIR 16개: 이 중 TREC-COVID, NFCorpus, Touché-2020, TREC-NEWS, Robust04, Signal-1M, BioASQ 7개는 학습 데이터와 겹치지 않는 OOD 데이터셋임.
- AIR-BENCH (zero-shot): Arxiv, Finance, Healthcare, Law, News 5개 도메인
- 지표는 모두 nDCG@10.
- 비교 baseline:
- TopK-PercPos:
bge-reranker-v2-gemma점수 기준으로 positive 점수의 95%를 넘는 hard negative를 걸러내는 방식 - CE Distill:
bge-reranker-v2-gemma점수를 teacher로 쓰는 cross-encoder distillation
- TopK-PercPos:
A. Retriever: BEIR
| Backbone | 방식 | Avg 16 | Avg 7 (OOD) |
|---|---|---|---|
| E5 (base) | Default | 0.508 | 0.425 |
| TopK-PercPos | 0.511 | 0.431 | |
| CE Distill | 0.514 | 0.436 | |
| Stage 1 Remove | 0.510 | 0.428 | |
| Stage 1 Remove HN | 0.511 | 0.432 | |
| Stage 1 RLHN | 0.514 | 0.437 | |
| Stage 2 Remove | 0.506 | 0.423 | |
| Stage 2 Remove HN | 0.511 | 0.431 | |
| Stage 2 RLHN | 0.515 | 0.445 | |
| Qwen2.5-7B | Default | 0.504 | 0.441 |
| Stage 2 Remove HN | 0.502 | 0.433 | |
| Stage 2 RLHN | 0.518 | 0.454 |
- RLHN이 가장 좋음: 두 backbone 모두 Stage 2 RLHN이 최고 성능을 기록하며, 특히 OOD 평균에서 향상 폭이 큼 (E5 +2.0, Qwen +1.3).
- Remove는 오히려 손해: 샘플 전체를 버리는 Remove는 Stage 2에서 Default보다 낮아짐. false negative가 있는 샘플은 대부분 MS MARCO의 유용한 학습 신호이므로, 버리기보다 고쳐서 쓰는 것이 나음.
- Remove HN보다 RLHN: false negative를 단순히 빼는 것보다 positive로 옮겨 추가 정답 신호로 활용 하는 것이 더 효과적임.
- Baseline 비교: TopK-PercPos보다 좋고, reranker를 teacher로 쓰는 CE Distill과는 비슷하거나 조금 높은 수준임.
- 통계적 유의성: Default 대비 E5는 16개 중 10개, Qwen2.5-7B는 16개 중 14개 데이터셋에서 유의한 향상을 보임.
B. Retriever: AIR-BENCH
| Backbone | 방식 | Arxiv | Finance | Health | Law | News | Avg 5 |
|---|---|---|---|---|---|---|---|
| E5 (base) | Default | 0.345 | 0.401 | 0.521 | 0.117 | 0.455 | 0.368 |
| CE Distill | 0.372 | 0.430 | 0.536 | 0.168 | 0.498 | 0.401 | |
| Stage 1 RLHN | 0.362 | 0.421 | 0.522 | 0.123 | 0.465 | 0.379 | |
| Stage 2 RLHN | 0.356 | 0.440 | 0.521 | 0.138 | 0.476 | 0.386 | |
| Qwen2.5-7B | Default | 0.325 | 0.391 | 0.479 | 0.115 | 0.430 | 0.348 |
| Stage 2 RLHN | 0.330 | 0.418 | 0.494 | 0.133 | 0.450 | 0.365 |
- RLHN은 Default 대비 E5 +1.8, Qwen +1.7 향상됨. Finance, Law, News에서 향상이 두드러짐.
- 다만 AIR-BENCH에서는 CE Distill이 RLHN보다 높음 (0.401 vs 0.386). RLHN은 reranker teacher 없이 학습 데이터만 고친다는 점에서 파이프라인이 더 단순하다는 장점이 있음.
C. Reranker: Qwen2.5-3B
| 방식 | Avg 16 | Avg 7 (OOD) |
|---|---|---|
| Default | 0.575 | 0.479 |
| Stage 1 RLHN | 0.580 | 0.489 |
| Stage 2 RLHN | 0.583 | 0.497 |
- Stage를 거칠수록 성능이 꾸준히 오르며, OOD에서 +1.8 향상됨. Robust04는 0.531 → 0.589로 크게 오름.
- 반면 Climate-FEVER(0.457 → 0.430), Signal-1M(0.292 → 0.274)처럼 떨어지는 데이터셋도 있음.
D. 추가 분석
학습 데이터 크기: 100K, 250K, 400K, 680K로 크기를 바꿔도 RLHN의 향상은 유지되며, 데이터가 많을수록 향상 폭이 커지는 경향을 보임. 특히 AIR-BENCH에서 이 경향이 뚜렷함.
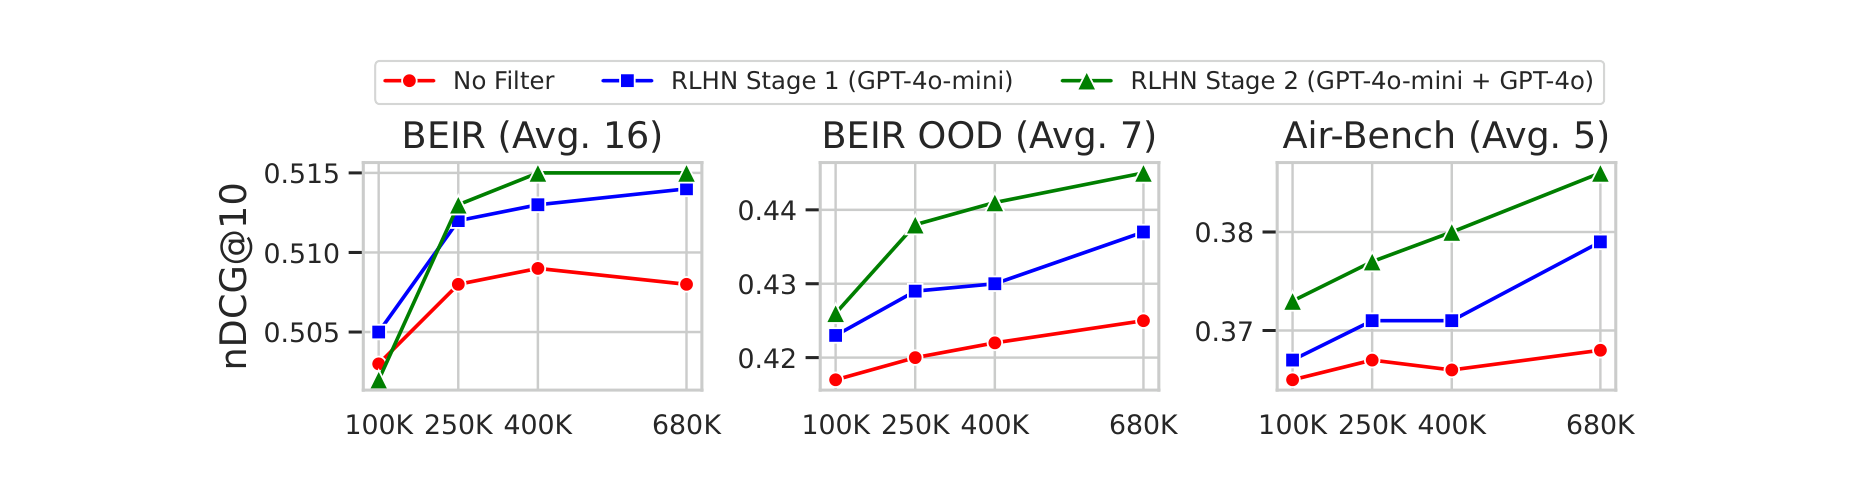
- Hard negative 개수: RLHN 데이터로 학습할 때 1 → 3 → 7 → 9개로 늘릴수록 BEIR 평균이 0.504 → 0.512 → 0.515 → 0.518로 꾸준히 오름. false negative를 정리하면 hard negative를 많이 써도 손해가 적음.
- Reranker는 false negative 탐지기로 부족함: 기존 reranker 6종으로 RLHN이 찾은 false negative를 얼마나 잡아내는지 측정함.
- FiQA·HotpotQA 기준 상위 reranker도 52.5~63.8% 정도만 찾아냄.
- 저자들은 reranker 자체가 false negative가 섞인 데이터로 학습되었기 때문이라고 추정함.
- 사람 라벨과의 일치도: 670개 query–hard negative 쌍을 사람 3명이 LLM 예측을 모르는 상태로 라벨링함.
- Cohen’s κ는
GPT-4o-mini0.320,GPT-4o0.390으로 GPT-4o가 더 높지만, 절대값은 fair 수준에 그침.
- Cohen’s κ는
E. 정성 분석
- 탐지된 false negative를 살펴보면 크게 4가지 유형으로 나뉨.
- LLM이 잘못 탐지한 경우: 실제로는 관련 없는 문서를 false negative로 판정함.
- 기존 정답이 틀린 경우: NHL 창설 연도를 묻는 질의에서 정답 문서는 1997년, false negative로 잡힌 문서는 실제 정답인 1917년을 담고 있음.
- 질의가 모호한 경우: “yin and yang”처럼 너무 일반적인 질의는 해석에 따라 여러 문서가 모두 관련 있음.
- 부분적으로 맞는 경우: 질의에 일부만 답하는 문서가 false negative로 잡힘.
- 2번 유형은 false positive도 실제로 존재한다는 뜻이므로, 기존 정답을 검사하지 않는 현재 방식의 한계와도 연결됨.
4. 결론
- 대규모 학습 데이터를 무작정 쓰는 것보다 데이터 품질 관리 가 더 중요함을 보임. 15개 중 8개 데이터셋을 제거해 2.35배 작은 데이터로 BEIR +1.0을 달성함.
- 저렴한 LLM과 비싼 LLM을 이어 붙인 cascade로 false negative를 찾아 positive로 relabeling 하는 RLHN 을 제안함.
- RLHN은 retriever와 reranker 모두에서, 특히 OOD 데이터셋과 zero-shot AIR-BENCH에서 일관된 향상을 보임.
- 정제된 학습 데이터셋을 Hugging Face(
rlhn)에 공개함. - 한계:
- 기존 정답 문서의 오류인 false positive는 다루지 않음. 정성 분석에서 정답이 틀린 사례가 이미 확인됨.
- Stage 2 비용이 약 3,000 USD로, 1M 쌍 이상 규모로 확장하기 어려움. 저자들은 Qwen3 같은 오픈소스 judge를 향후 과제로 제시함.
- 사람 라벨과의 Cohen’s κ가 0.39 수준이라 LLM judge의 판정을 그대로 신뢰하기 어려움.
- 본문에서 언급한 향상 폭(BEIR Stage 1 +2.0, Stage 2 +3.2 등)이 표의 평균값과 맞지 않음. 위 정리는 표의 수치를 기준으로 함.
- Multilingual, long-context retrieval과 ColBERT 같은 multi-vector 모델은 실험하지 않음.
This post is licensed under CC BY 4.0 by the author.