Written By. Filip J. Kucia, Barbara M. Gawlik (Warsaw University of Technology, Sparrows AI) / CIKM 2026
1. 문제 정의
- 배포 전 RAG 평가의 관행: 실제 사용 로그가 없는 배포 전 단계에서는 대상 코퍼스로부터 LLM이 질문–정답 쌍을 생성해 평가셋으로 쓰는 것이 일반적임.
- 생성 비용이 거의 없고 규모를 쉽게 키울 수 있어, retriever·chunking·벡터 DB 같은 구성 선택의 근거로 널리 쓰임.
- RAGAS, ARES, RAGChecker 등 최근 평가 프레임워크는 retrieval과 generation을 분리해 측정하지만, 평가셋 자체의 분포가 실제 트래픽과 같은가는 다루지 않음.
- 합성 질문과 실제 질문의 성격 차이:
- 합성 생성은 다양성을 지시받기 때문에 코퍼스 전체를 고르게 훑고, 문서에 근거한 완결된 문장으로 질문을 만듦.
- 실제 사용자는 시간표, 시험 일정, 서류 제출처럼 급한 행정 업무에 몰리고, “세션 종료일?”, “시간표?”처럼 짧게 묻고, 코퍼스에 없는 실시간·개인 정보를 묻기도 함.
- 기존 연구의 한계:
- DataMorgana처럼 질문 분포를 설정할 수 있는 생성기도 결국 “미래 트래픽은 이럴 것”이라는 가정에 의존함.
- 대학 챗봇 사례 연구들은 사용성·구조를 평가했을 뿐, 합성 평가셋과 실제 학생 질문의 분포 차이를 정량화하지 않음.
- 답할 수 없는 질문에 대한 거절·전달 능력은 별도 벤치마크로 연구되지만, 합성 평가셋에는 구조적으로 이런 질문이 빠져 있음.
- 핵심 질문:
- 합성 질문과 실제 질문은 어떤 차원에서, 얼마나 다른가?
- 그 차이가 retrieval 구성 선택을 실제로 바꾸는가?
- 배포 전에 적은 비용으로 이 위험을 감지할 수 있는가?
2. 해결 방법
A. 전체 구조: 단일 시스템 사례 연구
- 바르샤바 공과대학 수학·정보과학부의 학사 행정 챗봇
MiNIonek을 대상으로, 같은 코퍼스·같은 retriever에 합성 질문 1,851개와 실제 학생 질문 322개를 각각 넣어 비교함. - 새 모델이나 학습 기법을 제안하는 논문이 아니라, 평가셋 분포 차이를 다섯 가지 차원으로 정량화하고 배포 전 체크리스트를 제안하는 짧은 분석 논문임 (CIKM short paper, 6쪽).
B. RAG 시스템 구성
| 항목 | 설정 |
|---|
| 도메인 | 시간표, 장학금, 강의계획서, 행정 절차 등 학사 정보 |
| 코퍼스 | 학부 공식 웹페이지와 PDF 문서. 색인된 페이지·문서 하나를 source 로 부름 |
| 임베딩 | BAAI/bge-m3 |
| Dense 전용 | ChromaDB |
| Dense + Hybrid | Qdrant (dense 벡터와 BM25 sparse 벡터를 함께 저장) |
| 비교 구성 | ChromaDB dense, Qdrant dense, Qdrant hybrid 3가지 |
- reranker, chunking 설정, hybrid 결합 방식(가중치·RRF 여부), 코퍼스 언어는 명시되지 않음.
C. 질문셋 구축
① 합성 질문
- Google
Gemini Notebook(구 NotebookLM)의 기본 인터페이스로 생성함. 통제된 과학적 생성기가 아니라 실무자가 빠르게 평가셋을 만드는 대표적인 방식으로 선택했다고 밝힘. - 165개 source에서 1,851개 질문을 얻었고, 생성 근거 문서가 곧 정답 source이므로 100% 평가 가능함.
② 실제 질문
- 배포 전에는 로그가 없으므로, 재학생에게 “최근 학업과 관련해 답이 필요했던 질문”을 묻는 구조화된 설문을 진행함.
- 중복 제거 후 응답자 89명, 질문 322개를 확보함.
③ 정답 source 라벨링
- 학부 재학생이면서 코퍼스를 직접 구축한 도메인 전문가 2명이 라벨링함. 질문 집합을 둘로 나눠 한 질문당 한 명이 라벨을 달고, 여러 절차에 걸친 질문만 함께 검토함.
- 개인 맥락이 필요하거나, 코퍼스에 없는 실시간 정보가 필요하거나, 하나의 문서로 대응시키기 어려운 질문은 not directly evaluable 로 분류함.
- 결과적으로 322개 중 165개만 정답 source가 있고, 157개(49%)는 retrieval 평가에서 제외됨.
- 카테고리 체계: 실제 질문을 학생 관점의 업무 단위로 open coding해 만들고, 체계를 고정한 뒤 합성 질문에 동일하게 적용함. 실제 질문 18개, 합성 질문 17개 카테고리가 나옴.
D. 다섯 가지 비교 차원
| 차원 | 측정 방법 | 배포 전 측정 | 필요한 라벨 |
|---|
| Intent 분포 | 카테고리 비율의 Gini, Top-3 비율, JS divergence | 가능 | 카테고리만 |
| 질문 길이 | 평균·중앙값 단어 수 | 가능 | 없음 |
| Source 커버리지 | 고유 source 수, Top-1/Top-3 source 비율 | 가능 | 질문→페이지 대략적 매핑 |
| 평가 가능성 | 정답 source가 존재하는 비율 | 가능 | 질문→페이지 대략적 매핑 |
| Retrieval 지표 | Hit@k, MRR@10 | retriever 실행 필요 | 정답 source |
- Gini: 카테고리 비율이 균등하면 0, 한 카테고리에 몰리면 1.
- Jensen–Shannon divergence: 두 카테고리 분포 $P$, $Q$의 차이를 0(동일)~1 bit(겹침 없음)로 측정함.
\[\text{JS}(P \,\|\, Q) = \frac{1}{2}\text{KL}(P \,\|\, M) + \frac{1}{2}\text{KL}(Q \,\|\, M), \quad M = \frac{1}{2}(P + Q)\]
- Hit@k와 MRR@10: 질문 $q$의 정답 source 순위를 $\text{rank}_q$라 할 때,
\[\text{Hit@}k = \frac{1}{|Q|}\sum_{q \in Q} \mathbb{I}[\text{rank}_q \le k], \quad \text{MRR@10} = \frac{1}{|Q|}\sum_{q \in Q} \frac{\mathbb{I}[\text{rank}_q \le 10]}{\text{rank}_q}\]
- 인기도 baseline: 질문과 무관하게 항상 가장 많이 요청된 source 5개를 반환했을 때의 Hit@5. retrieval 점수 중 질의 분포의 쏠림만으로 설명되는 부분을 가늠하는 기준임.
E. 통계 검정
| 검정 | 용도 |
|---|
| Mann–Whitney U + Cliff’s $\delta$ | 두 집합의 질문 길이 차이와 효과 크기 |
| Bootstrap 10,000회 | $\Delta\text{Hit@5} = \text{Hit@5}{\text{authentic}} - \text{Hit@5}{\text{synthetic}}$의 95% 신뢰구간 |
| Cochran–Mantel–Haenszel | 카테고리를 통제한 뒤에도 성능 하락이 유의한지 |
| 크기 맞춘 subsampling 1,000회 | 합성셋이 커서 생긴 차이인지 확인 |
- Cliff’s $\delta$는 한 집합에서 뽑은 값이 다른 집합 값보다 클 확률에서 작을 확률을 뺀 값으로, $\pm 1$에 가까울수록 두 분포가 거의 겹치지 않음을 뜻함.
\[\delta = P(X > Y) - P(X < Y)\]
3. 실험
A. 분포 비교
| 항목 | 합성 | 실제 |
|---|
| 질문 수 | 1,851 | 322 (평가 가능 165) |
| 카테고리 수 | 17 | 18 |
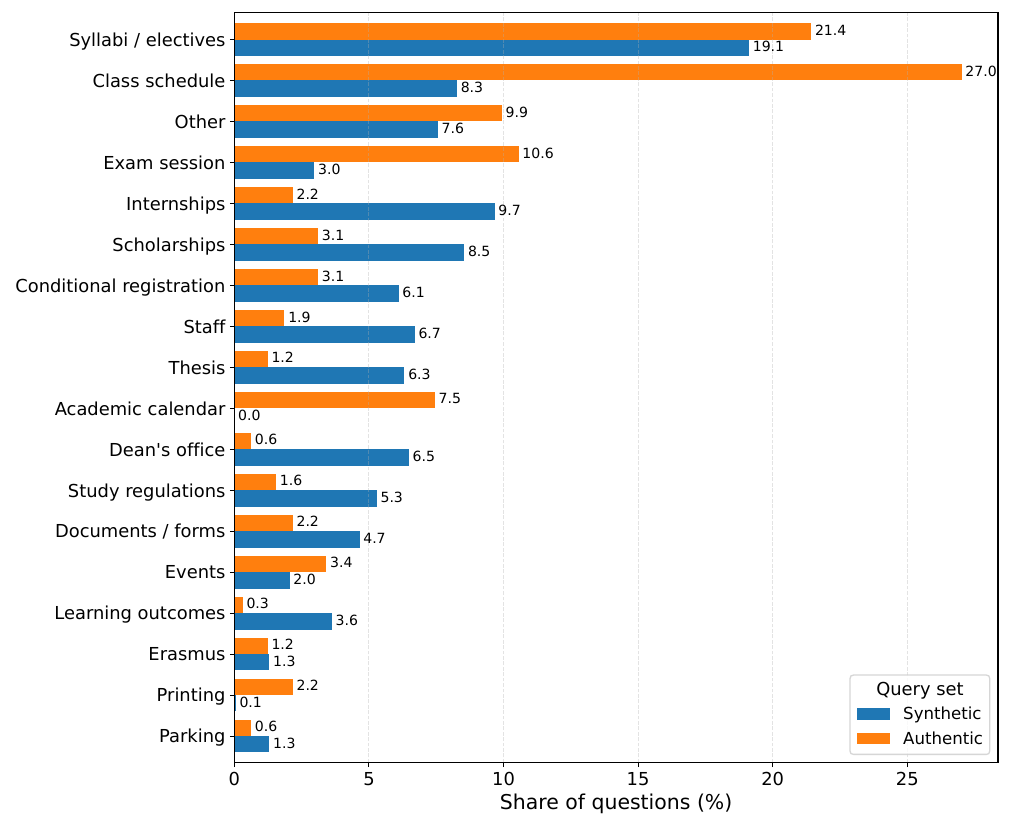
| 최다 카테고리 | 강의계획서·선택과목 (19.1%) | 시간표 (27.0%) |
| Gini / Top-3 카테고리 비율 | 0.37 / 37.3% | 0.59 / 59.0% |
| 평균 / 중앙값 길이 (단어) | 15.7 / 15 | 6.8 / 6 |
| 고유 source 수 | 165 | 53 |
| Top-1 / Top-3 source 비율 | 5.5% / 15.1% | 25.3% / 44.4% |
| 평가 불가 비율 | 0% | 49% |
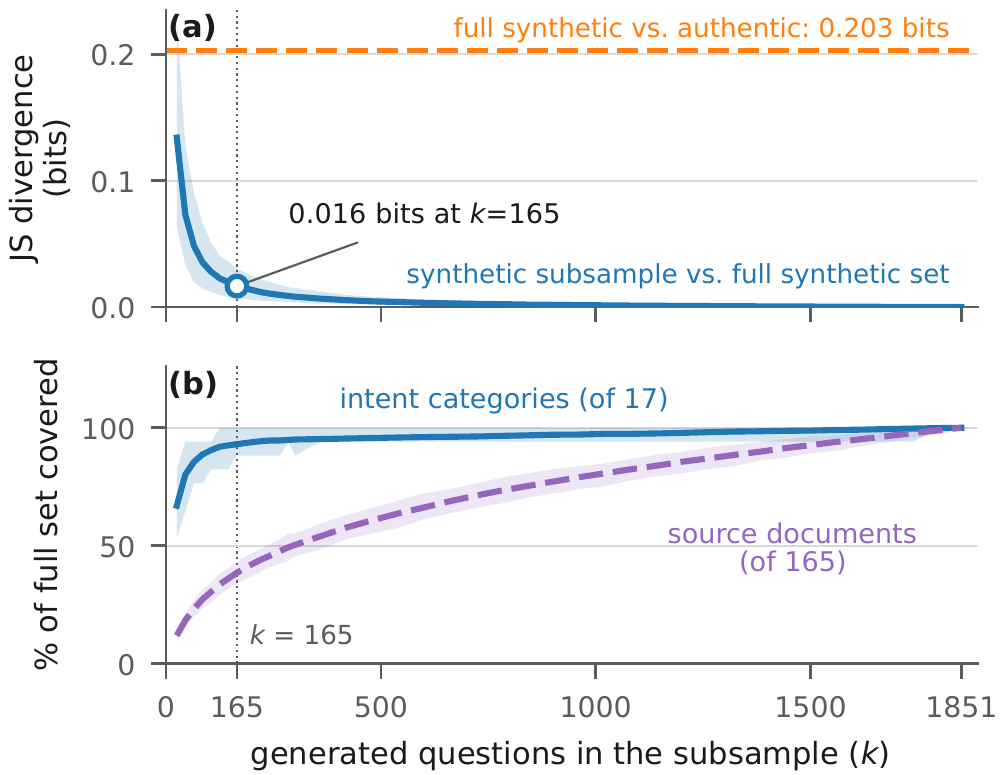
- Intent가 몰려 있음: 두 카테고리 분포의 JS divergence는 0.203 bits.
- 시간표는 실제 27.0%로 1위지만 합성에서는 8.3%로 4위임.
- 학사일정은 실제 7.5%인데 합성에는 아예 없음.
- 반대로 인턴십은 합성 9.7% vs 실제 2.2%로 약 4배, 학위논문 절차는 6.3% vs 1.2%로 약 5배 과대표집됨.
- 질문이 절반 이하로 짧음: Mann–Whitney $p < 0.001$, Cliff’s $\delta = 0.917$로 두 길이 분포가 거의 겹치지 않음.
- 합성 예: “다음 학기 등록을 위해 학생이 충족해야 하는 행정 조건은 무엇인가?” / 실제 예: “세션 종료일?”, “시간표?”
- 트래픽이 소수 문서에 집중됨: 학사일정 페이지 하나가 평가 가능한 실제 질문의 25.3%를 차지함.
B. 질문셋 크기 효과
- 합성셋에서 $k$개를 1,000번 무작위 추출해, 크기 차이가 격차를 만든 것인지 확인함.
| 측정 | 합성 subsample ($k = 165$) | 비교 대상 |
|---|
| 전체 합성셋과의 JS divergence | 0.016 bits (95% 범위 0.007–0.031) | 합성 vs 실제 0.203 bits |
| Hybrid Hit@5 | 0.896 ± 0.023 (최저 0.824) | 실제 질문 0.527 |
- 크기를 맞춰도 분포 격차와 성능 격차 모두 그대로임.
- 합성 질문을 더 만들어도 새 intent는 생기지 않음: 165개만으로 17개 카테고리의 93%를 커버하고, 이후에는 source 커버리지만 계속 늘어남. 추가 생성은 코퍼스 폭을 넓힐 뿐 실제 학생 수요 쪽으로 다가가지 않음.
C. Retrieval 성능
| 구성 | 질문셋 | Hit@1 | Hit@3 | Hit@5 | Hit@10 | MRR@10 | ΔHit@5 [95% CI] | 지연 (s) |
|---|
ChromaDB dense | 합성 | 0.532 | 0.786 | 0.820 | 0.843 | 0.662 | | 0.33 |
| | 실제 | 0.321 | 0.461 | 0.527 | 0.576 | 0.400 | −0.293 [−0.37, −0.22] | |
Qdrant dense | 합성 | 0.555 | 0.814 | 0.849 | 0.873 | 0.687 | | 1.57 |
| | 실제 | 0.315 | 0.497 | 0.545 | 0.582 | 0.413 | −0.304 [−0.38, −0.23] | |
Qdrant hybrid | 합성 | 0.566 | 0.858 | 0.896 | 0.910 | 0.709 | | 2.70 |
| | 실제 | 0.321 | 0.461 | 0.527 | 0.576 | 0.400 | −0.369 [−0.44, −0.29] | |
- 모든 구성에서 Hit@5가 29~37점 하락: CMH 검정으로 카테고리를 통제해도 유의함 ($p < 0.001$). 두 집합에 모두 있는 상위 7개 카테고리 중 6개에서 하락함.
- 유일한 예외는 시간표로, 실제 질문의 넓은 키워드가 메인 시간표 페이지와 쉽게 맞는 반면 합성 질문은 지나치게 복잡해 오히려 검색이 어려웠음.
- 합성에서 1등인 hybrid가 하락폭도 최대: 합성 Hit@5 0.896으로 최고지만 실제에서는 0.527로 dense 단독(0.545)보다 낮음.
- 실제 질문에서는 세 구성이 사실상 같음: BM25는 정확한 키워드 일치에 의존하므로, 키워드가 많은 긴 합성 질문에서만 이득을 주고 짧은 실제 질문에는 기여하지 않음.
- 같은 Qdrant 안에서 hybrid는 dense 대비 지연 1.7배(2.70s vs 1.57s), 가장 빠른 ChromaDB 대비 8배.
- 합성 결과만 보고 hybrid를 고르면 정확도 이득 없이 지연만 늘어나는 셈임.
- 점수 일부는 쏠림 효과: 인기도 baseline Hit@5가 실제 질문 0.545, 합성 질문 0.233. 실제 질문의 retrieval 점수 중 상당 부분이 쏠림만으로도 나온다는 뜻이며, retrieval 지표만으로는 이를 분리할 수 없어 앞의 네 차원이 필요하다고 주장함.
D. 평가 가능성
- 실제 질문 49%(157/322)는 정적 source 하나에 대응되지 않음.
- 카테고리별로 불균등함: 가장 많이 묻는 시간표는 47%, 강의계획서·선택과목은 30%만 정적 source로 대응되는 반면, 학사일정은 100% 대응됨. 즉 평가셋이 가장 강한 곳이 수요가 가장 약한 곳임.
- 이런 질문에는 retrieval이 아니라 거절, 되묻기, 담당자 연결이 정답 행동이지만 합성 평가셋은 이를 전혀 시험하지 않음.
E. 배포 전 체크리스트
| 단계 | 내용 |
|---|
| 1 | 합성 질문셋으로 코퍼스 전반의 retrieval 능력과 파이프라인 커버리지 검증 |
| 2 | 실제 사용자나 도메인 대리인으로부터 실제 질문 50~100개 수집 (정식 라벨링 불필요) |
| 3 | 두 집합을 intent 분포, 길이, source 커버리지, 평가 가능성 기준으로 비교 |
| 4 | 합성 점수가 아니라 실제 질문 특성에 맞춰, 지연까지 고려해 retrieval 구조 확정 |
| 5 | 답할 수 없는 질문에 대한 거절 정책과 담당자 연결 조건 구현 |
4. 결론
- 합성 질문셋은 이상적 조건에서의 최대 retrieval 능력과 코퍼스 커버리지를, 실제 질문셋은 짧고 모호한 입력에 대한 강건성을 측정하는 서로 보완적인 양 극단이라는 관점을 제시함.
- 학사 챗봇 사례에서 두 분포는 intent 집중도, 길이, source 커버리지, 평가 가능성 모두에서 크게 달랐고, Hit@5는 29~37점 떨어짐.
- 합성 점수로 고르면 BM25 hybrid가 선택되지만, 실제 질문에서는 정확도 이득 없이 지연만 최대 8배 늘어남.
- 소량의 실제 질문과 라벨이 거의 필요 없는 네 가지 분포 지표만으로 배포 위험을 사전에 감지할 수 있다고 주장함.