ARHN: Answer-Centric Relabeling of Hard Negatives with Open-Source LLMs for Dense Retrieval
ARHN: Answer-Centric Relabeling of Hard Negatives with Open-Source LLMs for Dense Retrieval
Written By. Hyewon Choi, Jooyoung Choi, Hansol Jang, Hyun Kim, Chulmin Yun, ChangWook Jun, Stanley Jungkyu Choi (LG AI Research)
1. 문제 정의
- Hard negative mining의 함정: dense retriever는 질의, positive, hard negative로 구성된 대규모 데이터로 contrastive 학습을 함.
- hard negative는 보통 학습 중인 retriever, BM25, reranker가 높게 점수를 준 문서 중에서 뽑음.
- 이 과정은 얼마나 어려운지만 보고, 그 문서에 정답이 들어 있는지는 확인하지 않음.
- 그 결과 정답을 직접 담고 있거나 일부 근거를 담은 문서가 negative로 들어가고, 모델은 정답 문서를 밀어내도록 학습됨.
- 기존 연구의 한계: RLHN은 같은 문제를 LLM 판정으로 해결했지만
GPT-4o-mini,GPT-4o같은 상용 API에 의존해 비용이 크고 재현이 어려움.- 또한 문서 전체를 놓고 관련성을 판단하므로, positive와 hard negative가 배경 문맥을 많이 공유하면 비교가 어려움.
- 핵심 질문: 오픈소스 LLM만으로, 문서에 실제 정답 근거가 있는지 를 기준으로 hard negative를 정제할 수 있을까?
2. 해결 방법
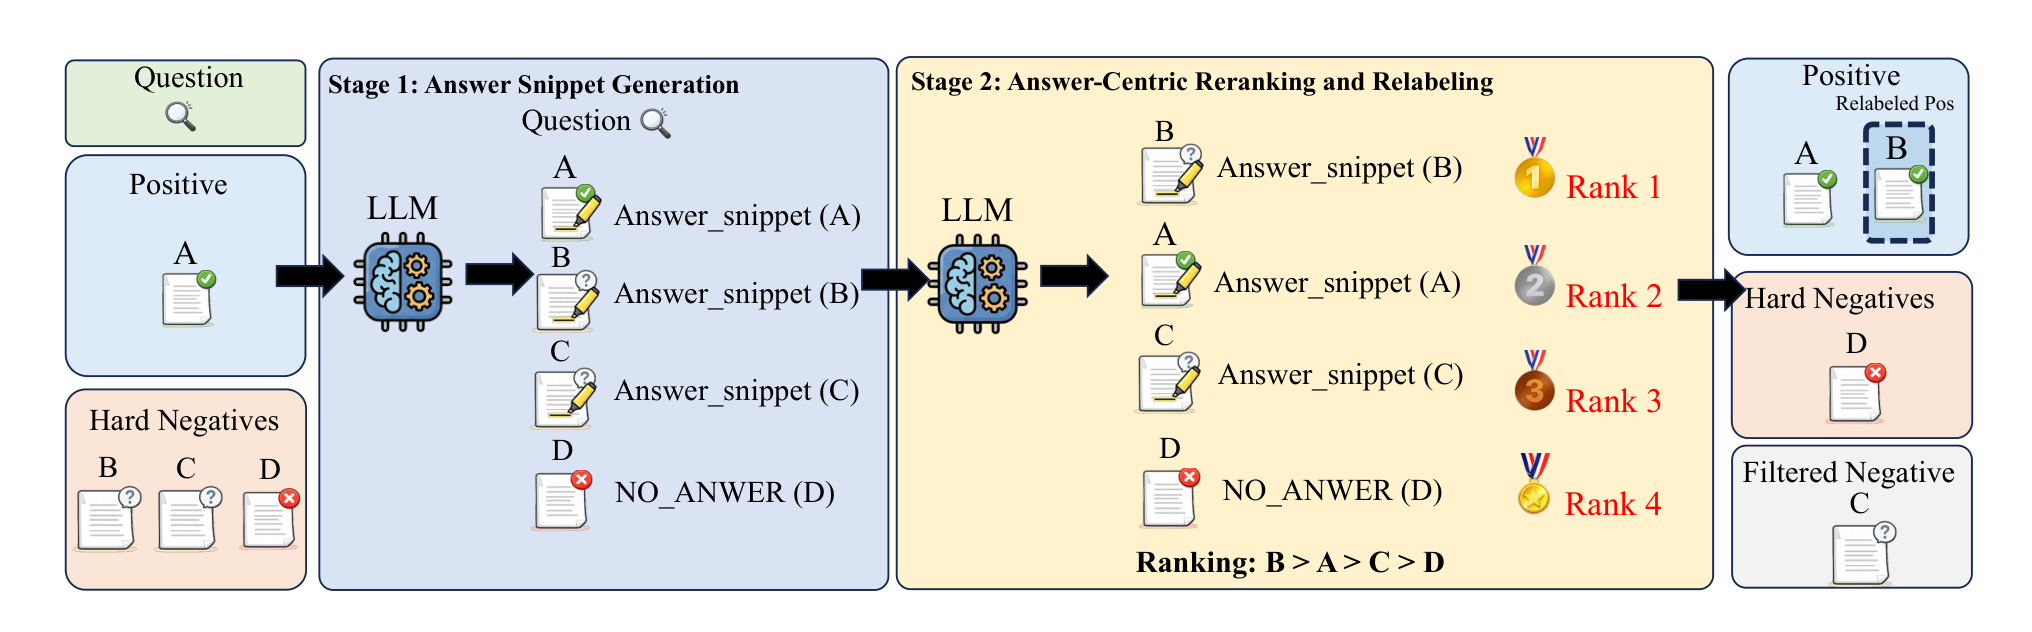
A. 전체 구조: ARHN (Answer-Centric Relabeling of Hard Negatives)
- 두 단계로 구성되며, 두 단계 모두 같은 오픈소스 LLM을 사용함.
- Stage 1: 각 문서에서 질의에 대한 answer snippet을 뽑거나, 없으면
NO_ANSWER를 출력함. - Stage 2: 뽑은 snippet들을 listwise로 정렬하고, positive보다 위/아래에 있는지에 따라 라벨을 다시 매김.
- Stage 1: 각 문서에서 질의에 대한 answer snippet을 뽑거나, 없으면
B. Stage 1: Answer Snippet Generation
- 질의 $q$ 하나와 positive 1개, hard negative $N$개를 한 번에 LLM에 넣음.
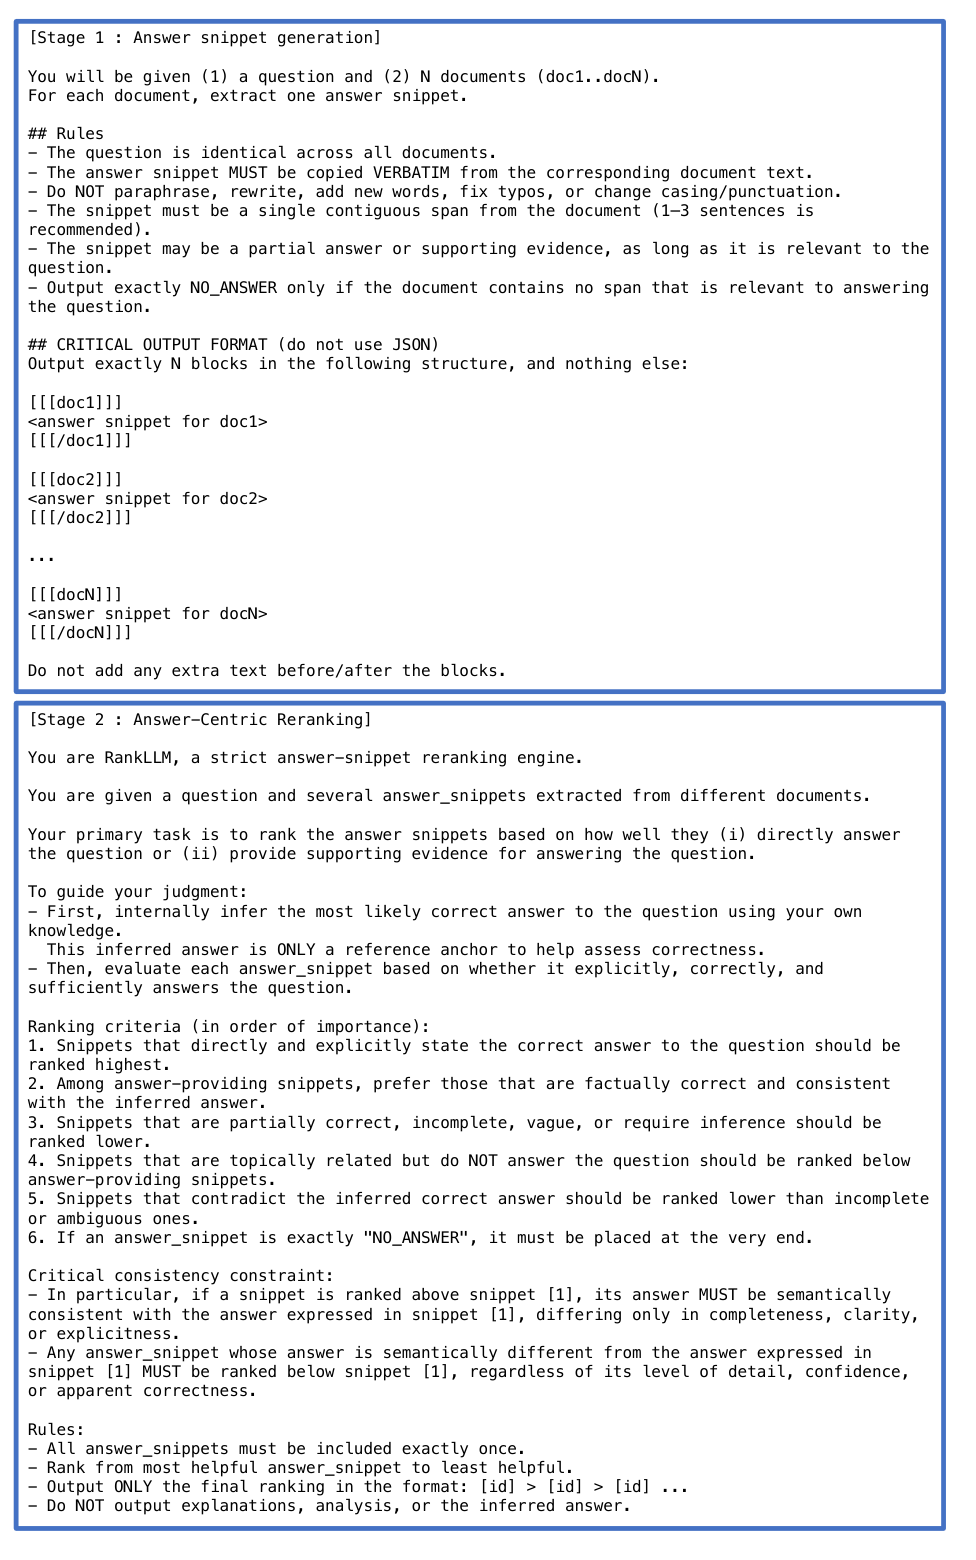
- 각 문서 $d$에 대해 answer snippet $a$를 뽑음.
- 생성이 아니라 추출: snippet은 문서에서 그대로 복사한 연속 구간 이어야 함 (1~3문장 권장).
- 새로 답을 쓰지 못하게 막아서 hallucination을 줄이고, “이 문서 안에 답이 있는가”에만 집중하게 함.
- 부분적인 답이나 근거여도 질의와 관련 있으면 snippet으로 뽑음.
- 관련 구간이 전혀 없으면
NO_ANSWER를 출력함.
- 출력은 $N+1$개의 튜플이 되고, hard negative에서
NO_ANSWER가 아닌 snippet이 나오면 false negative 후보가 됨.
C. Stage 2: Answer-Centric Reranking
- 문서 원문이 아니라 Stage 1에서 뽑은 snippet들만 놓고 listwise로 순위를 매김.
- 순위 기준 (중요도 순)
- 정답을 직접적이고 명시적으로 말하는 snippet이 가장 위
- 그중에서도 사실적으로 맞는 snippet을 우선
- 부분적이거나 모호하거나 추론이 필요한 snippet은 아래
- 주제만 관련 있고 답은 없는 snippet은 더 아래
- 정답과 모순되는 snippet은 그보다 더 아래
NO_ANSWER는 맨 끝
- Positive 기준 일관성 제약: 프롬프트에서 snippet [1]이 원래 positive의 snippet임.
- positive보다 위에 놓이려면 positive와 같은 답 이어야 하고, 완결성이나 명확성만 더 나아야 함.
- 답 자체가 다르면 아무리 자세해도 positive 아래에 둠.
- LLM이 내부적으로 정답을 추론해 기준으로 삼되, 그 추론 내용은 출력하지 않음.
D. 순위 기반 라벨 재구성
- 원래 positive의 순위 $\mathrm{rank}_q(i^+)$를 기준으로 각 hard negative $d_i^-$를 처리함.
| 조건 | 처리 | 의미 |
|---|---|---|
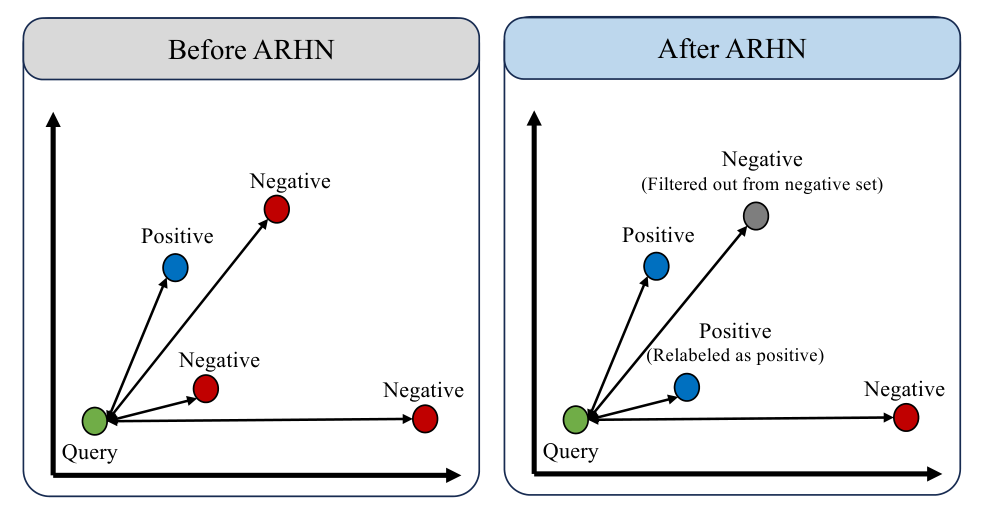
| $\mathrm{rank}_q(i) < \mathrm{rank}_q(i^+)$ | Relabel: positive 집합 $\mathcal{D}^+$로 이동 | positive와 같은 답을 더 직접적으로 담은 false negative |
$\mathrm{rank}_q(i) > \mathrm{rank}_q(i^+)$ 이고 $a_i^- \neq$ NO_ANSWER | Filter: negative 집합 $\mathcal{D}^-$에서 제거 | 일부 근거는 있지만 판단이 애매한 borderline 문서 |
$a_i^- =$ NO_ANSWER | Keep: negative로 유지 | 답이 없는 true hard negative |
- Filter 대상은 positive로 올리면 노이즈가 늘고, negative로 두면 유용한 신호를 밀어내므로 아예 학습에서 뺌.
- RLHN과 비교하면, RLHN은 positive 이상인 것만 relabel하고 나머지는 negative로 두지만, ARHN은 그 중간 영역을 따로 떼어 제거함.
E. 실험 설정
- 학습 데이터: RLHN과 동일하게 BGE collection 중 7개 데이터셋(MS MARCO, HotpotQA, NQ, FEVER, SciDocsRR, FiQA-2018, ArguAna), 약 680K 쌍을 사용함.
- 정제용 LLM:
Qwen3-8B,Qwen3-14B,Qwen3-32B로 비교하고 최종 결과는Qwen3-32B기준임.- 프롬프트당 positive 1개와 hard negative 최대 $N=10$개를 넣음.
- 두 단계 추론은 A100 16장으로 수행함.
- Retriever:
E5-base(110M, mean pooling): 5 epoch, learning rate 2e-5LG-ANNA-Embedding(Mistral-7B 기반): LoRA로 2 epoch, learning rate 1e-4
- Loss: 질의당 positive 1개, hard negative 7개와 in-batch negative로 InfoNCE 학습함. global batch size 128.
- 논문에 수식은 명시되어 있지 않아, 표준 InfoNCE 형태로 적음.
- 여러 seed로 학습한 평균을 보고함.
3. 실험
- 평가: BEIR 16개 데이터셋 (Quora, CQADupStack 제외), nDCG@10
- BioASQ, Robust04, Signal-1M, TREC-NEWS, Touché-2020, TREC-COVID, NFCorpus 7개는 학습 데이터와 겹치지 않는 OOD 데이터셋임.
- 비교 대상:
- No Refinement: 정제하지 않은 680K 데이터
- TopK-PercPos:
bge-reranker-v2-gemma점수 기준 95% 필터링 (NV-Retriever 방식) - RLHN:
GPT-4o-mini→GPT-4ocascade로 false negative를 relabel - ARHN(Filter / Relabel / R+F): filtering만, relabeling만, 둘 다 적용
A. BEIR 결과
| Backbone | 방식 | Avg 16 | Avg 7 (OOD) |
|---|---|---|---|
| E5 (base) | No Refinement | 0.508 | 0.425 |
| TopK-PercPos | 0.511 | 0.431 | |
| RLHN | 0.515 | 0.445 | |
| ARHN(Filter) | 0.510 | 0.427 | |
| ARHN(Relabel) | 0.511 | 0.432 | |
| ARHN(R+F) | 0.521 | 0.446 | |
| LG-ANNA (Mistral-7B) | No Refinement | 0.546 | 0.464 |
| ARHN(Filter) | 0.547 | 0.465 | |
| ARHN(Relabel) | 0.551 | 0.470 | |
| ARHN(R+F) | 0.554 | 0.475 |
- R+F가 가장 좋음: E5에서 No Refinement 대비 +1.3, RLHN보다도 +0.6 높음. 7B 모델에서도 +0.8 향상됨.
- OOD에서 효과가 더 큼: E5 기준 OOD 평균이 +2.1 오름. 다만 RLHN(0.445)과의 차이는 0.001로 거의 같음.
- Filter와 Relabel은 상호 보완적: 하나만 적용하면 +0.2~0.3에 그치지만, 둘을 함께 쓰면 +1.3으로 크게 오름.
- Relabel은 잘못 negative로 들어간 정답 문서를 positive로 바꿔 positive를 다양하게 만듦.
- Filter는 부분적으로만 관련 있는 문서를 negative에서 빼서, 그런 문서를 과하게 밀어내지 않게 함.
- Truncation 관점의 이점: 원래 positive의 정답 부분이 retriever의 max_seq_len 뒤에 있으면 학습 중에 보이지 않음. 앞부분에 정답이 있는 negative를 positive로 올리면 실제로 볼 수 있는 정답 신호가 생김.
B. PRHN vs ARHN: 원문 기준 vs snippet 기준
- Stage 1 없이 문서 원문을 그대로 listwise 정렬 하는 변형(PRHN)과 비교함. relabel/filter 규칙은 같음.
| 방식 | Avg 16 | Avg 7 (OOD) |
|---|---|---|
| PRHN (Passage-Centric) | 0.516 | 0.440 |
| ARHN (Answer-Centric) | 0.521 | 0.446 |
- positive와 hard negative는 어휘·문맥이 비슷해서 원문끼리 비교하면 헷갈리기 쉬움.
- snippet만 비교하면 공통 배경 문맥이 사라지고 답 부분만 남아 판단이 쉬워짐.
NO_ANSWER로 답 없는 문서를 미리 걸러내는 효과도 있음.
C. LLM 크기의 영향
| 정제 LLM | BEIR Avg 16 | 질의당 Relabel 수 | 질의당 Filter 수 | 사람 라벨과의 Cohen’s κ |
|---|---|---|---|---|
| (No Refinement) | 0.508 | - | - | - |
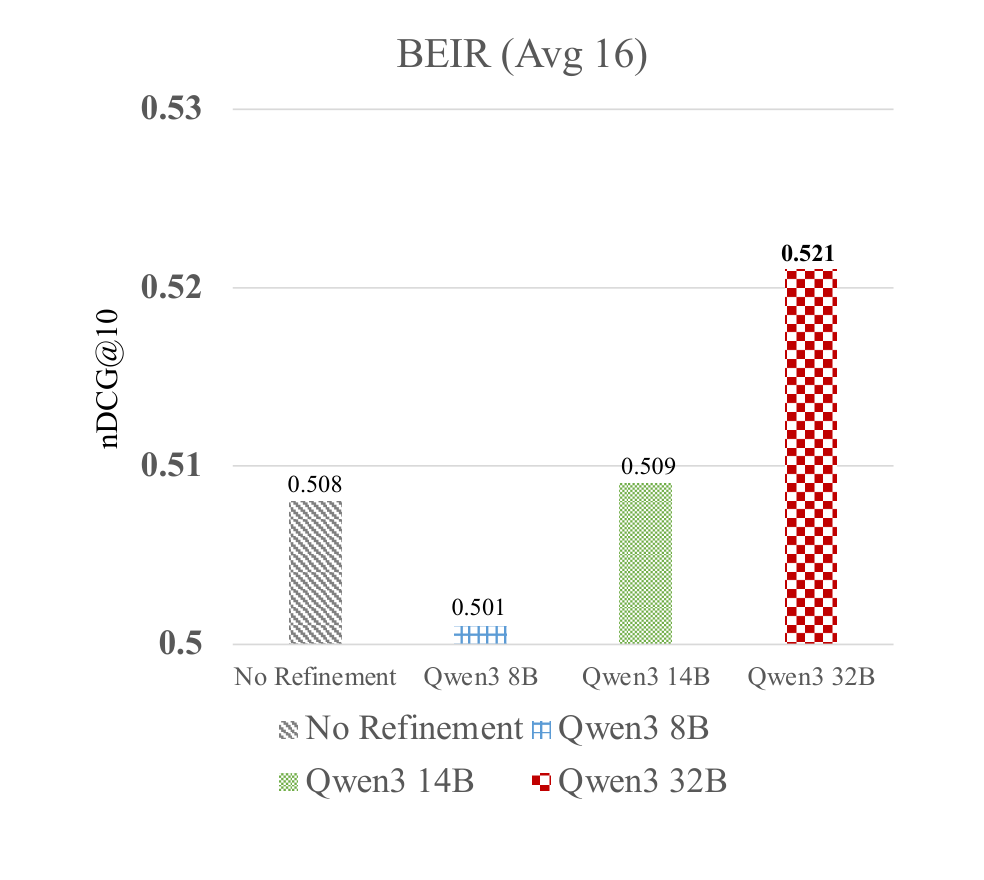
| Qwen3-8B | 0.501 | 3.1 | 3.9 | 0.312 |
| Qwen3-14B | 0.509 | 2.3 | 3.4 | 0.341 |
| Qwen3-32B | 0.521 | 1.6 | 2.2 | 0.373 |
- 작은 LLM은 오히려 해로움:
Qwen3-8B로 정제하면 정제하지 않은 것보다 성능이 떨어짐 (0.508 → 0.501). - 작을수록 공격적으로 수정함: 8B는 hard negative 10개 중 평균 7개를 relabel하거나 제거하는 반면, 32B는 3.8개만 건드림.
- 답이 없는 문서에서 snippet을 뽑거나, 부분적으로만 관련 있는 문서를 positive로 올리거나, 유용한 hard negative를 지우는 실수가 많아지는 것으로 해석함.
- 사람 라벨과의 일치도: 사람 2명이 500개 query–hard negative 쌍을 LLM 예측을 모르는 상태로 라벨링하고, 의견이 다르면 논의해서 하나로 정함.
- 모델이 클수록 κ가 높아지지만, 32B도 0.373 수준에 그침.
D. 정성 분석
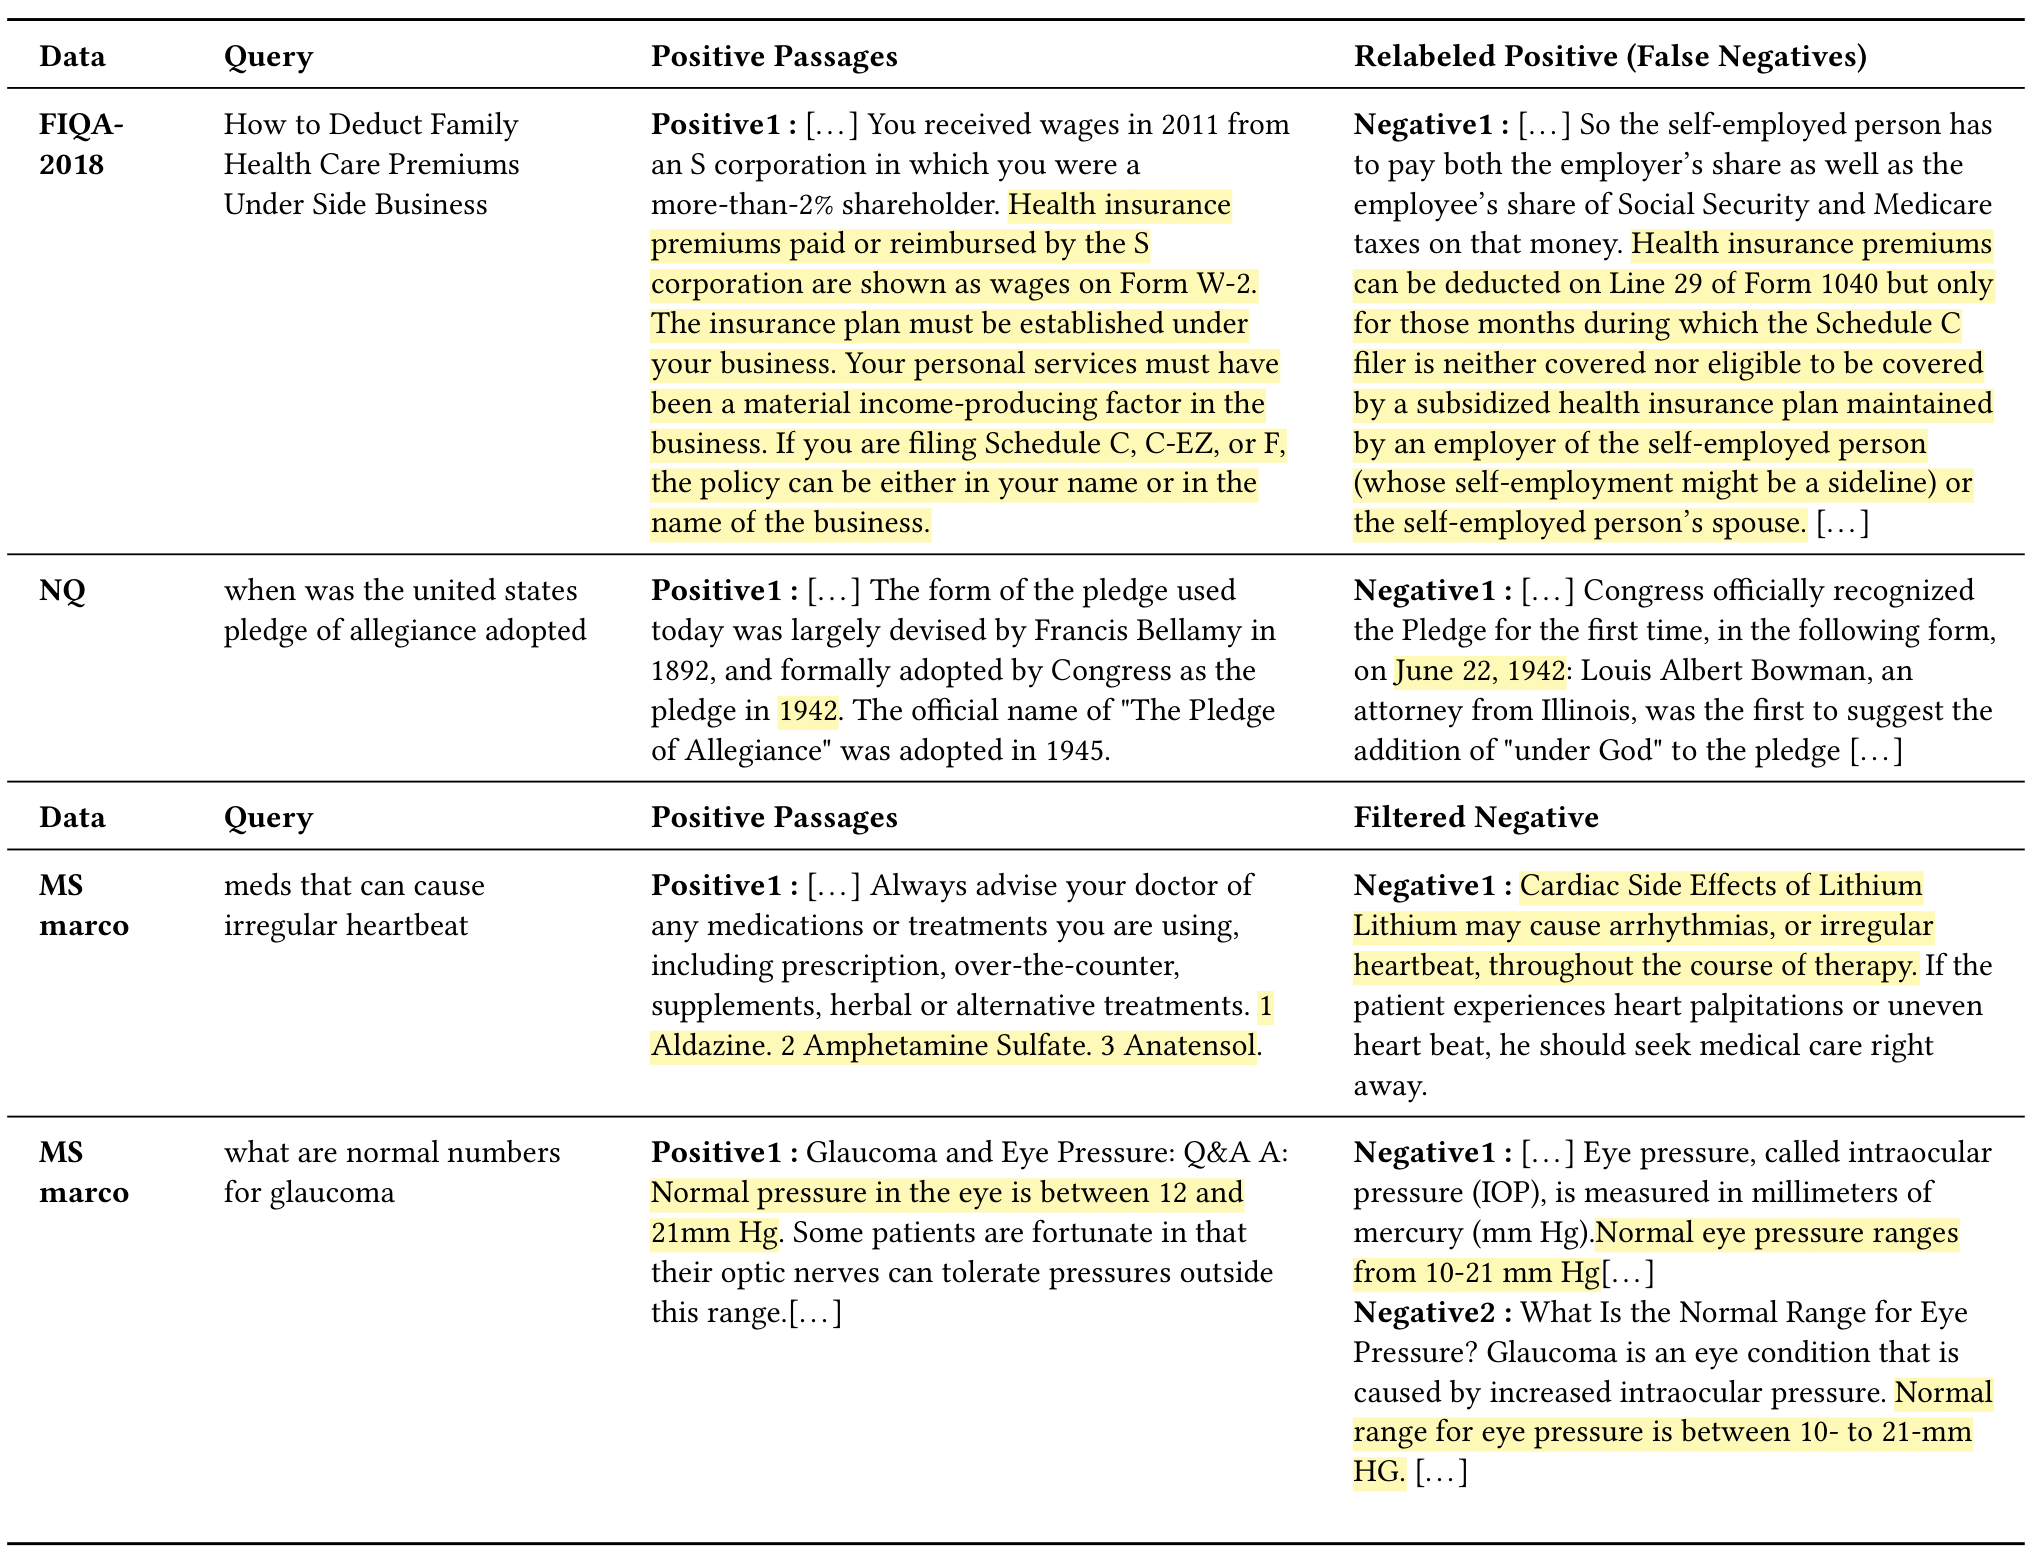
- 보완적인 근거 (FiQA-2018): “부업에서 가족 건강보험료를 공제하는 방법” 질의에서, positive는 보험이 사업체 명의로 가입되어야 한다는 조건을, relabel된 문서는 Form 1040 Line 29 공제 자격 조건을 설명함. 둘 다 필요한 정보이므로 positive가 여러 개인 것이 자연스러움.
- 더 구체적인 답 (NQ): 미국 국기에 대한 맹세가 채택된 시점을 묻는 질의에서, positive는 “1942년”까지만, relabel된 문서는 “1942년 6월 22일”까지 답함. 이 문서를 negative로 두면 더 좋은 근거를 밀어내도록 학습됨.
- 실제로 맞는 답 (MS MARCO): 부정맥을 일으키는 약을 묻는 질의에서, positive는 다른 약들을 나열하지만 filter된 문서는 리튬이 부정맥을 일으킬 수 있다고 설명함. 정답이 여러 개인 질의라 negative로 두면 안 되는 문서임.
- 거의 같은 답을 담은 negative (MS MARCO): 녹내장 정상 안압을 묻는 질의에서, positive는 12~21 mmHg, negative 두 개는 10~21 mmHg라고 답함. 사실상 같은 답을 negative로 학습시키는 모순된 신호가 됨.
4. 결론
- 문서에서 answer snippet을 먼저 추출하고, snippet끼리 listwise로 비교 해서 hard negative를 relabel하거나 filter하는 ARHN을 제안함.
- positive보다 위인 문서는 positive로 올리고, 아래지만 답이 있는 문서는 제거하고, 답이 없는 문서만 negative로 남기는 3단 규칙이 핵심임.
- 오픈소스
Qwen3-32B만으로 상용 API 기반 RLHN보다 BEIR 평균이 높았고, OOD에서 특히 효과가 컸음. - 한계:
- E5의 No Refinement, TopK-PercPos, RLHN 수치가 RLHN 논문의 표와 소수점까지 같아, baseline은 RLHN 논문 값을 그대로 가져온 것으로 보임. ARHN은 여러 seed 평균인데 baseline도 같은 조건인지 명시되어 있지 않음.
- OOD 평균에서 RLHN과의 차이는 0.001이고, seed별 분산이나 유의성 검정이 없어 OOD 우위는 판단하기 어려움.
- 7B 모델에서는 TopK-PercPos와 RLHN을 비교하지 않음.
- 오픈소스라서 비용 효율적이라고 주장하지만, A100 16장을 사용한 추론 시간이나 비용은 보고하지 않음.
- 정제 품질이 LLM 크기에 크게 좌우되어, 8B 수준에서는 오히려 성능이 떨어짐. 32B의 κ도 0.373으로 RLHN의
GPT-4o(0.390)와 비슷한 수준이며, 평가 샘플이 달라 직접 비교는 어려움. - hard negative 10개 중 32B 기준으로도 평균 3.8개가 relabel 또는 제거되는데, 학습에 필요한 hard negative 7개를 채우지 못하는 경우의 처리가 설명되어 있지 않음.
- positive를 기준점으로 쓰기 때문에, 원래 positive가 틀린 경우(false positive)는 바로잡지 못함.
This post is licensed under CC BY 4.0 by the author.