Search-by-Answer Bias in Retrieval Models
Search-by-Answer Bias in Retrieval Models
Written By. Adiel Avigad, Yoav Goldberg (Bar-Ilan University), Shauli Ravfogel (NYU Center for Data Science) / arXiv 2026
1. 문제 정의
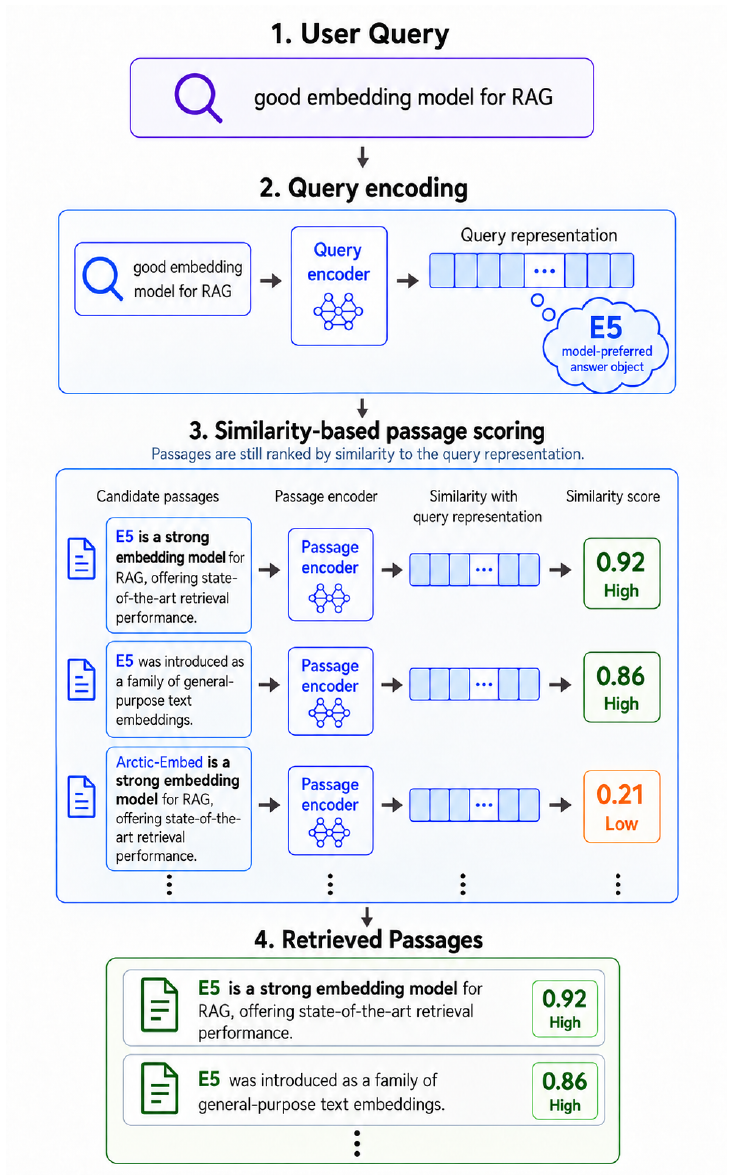
- Dense retriever에 기대하는 동작: 질의가 지정한 subject와 relation을 표현하는 passage를 찾는 것임. “가장 인기 있는 프로그래밍 언어는?”이라는 질의에는 “… is the most popular programming language” 같은 문장이 근거가 되어야 함.
- 다른 방식으로 동작할 가능성: retriever의 backbone은 world knowledge를 가진 언어 모델이라, 질의를 보는 순간 특정 정답을 떠올리고 그 정답이 들어 있는 passage 를 찾을 수 있음. 저자는 이를 search-by-answer bias 라 부름.
- 이 편향이 문제가 되는 상황:
| 상황 | 예 | 결과 |
|---|---|---|
| 정답이 여럿 | 한 질환에 치료법이 여러 개 | 가장 유명한 답 하나로 쏠림 |
| 사실이 바뀜 | 인기 언어가 시간에 따라 변함 | 과거 정답의 근거가 상위에 옴 |
| 폐쇄·동적 도메인 | 사내 문서, 최신 데이터 | 사전학습 지식이 무관하거나 틀림 |
- 정답이 하나이고 모델이 이미 아는 경우에는 오히려 유리하지만, 그 경우가 retrieval이 가장 덜 필요한 경우임.
- 기존 연구의 한계: dense retriever가 희귀 entity 질문에 약하다는 결과 (Sciavolino et al., 2021), retriever representation에서 정답 token을 복원할 수 있다는 결과 (Ram et al., 2023), DPR 검색이 사전학습 지식에 제약된다는 결과 (Reichman and Heck, 2024)는 있었음. 하지만 relation 일치를 통제한 상태에서 정답 object에 대한 선호가 retrieval 점수를 바꾸는지 여러 retriever로 검증한 연구는 없었음.
- 핵심 질문:
- 같은 relation을 표현하는 두 passage가 object만 다를 때, 모델이 아는 object가 든 쪽의 점수가 더 높은가?
- 모델이 아는 object가 틀린 relation과 함께 나와도, relation이 맞는 passage를 이기는가?
- 모델이 정답을 강하게 알수록 이 경향이 커지는가?
2. 해결 방법
A. 전체 구조
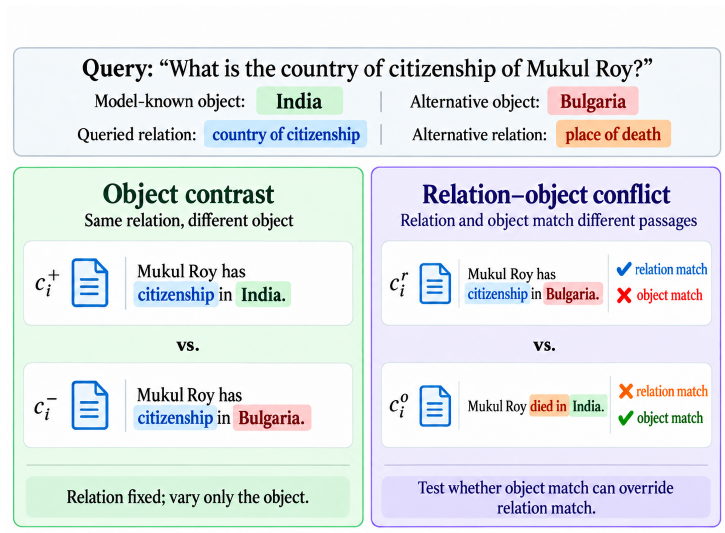
- 새 모델이 아니라 통제된 진단 실험 을 제안함. LAMA/TREx의 $(s, r, o)$ 삼중항으로 질의는 고정하고, passage의 object나 relation만 바꾼 최소 대조쌍을 만듦.
- 두 값을 각각 측정한 뒤 상관을 봄.
- $x$: retriever가 정답 object를 얼마나 “알고 있는가” (token-prediction 점수)
- $y$: retriever가 그 object가 든 passage에 점수를 얼마나 더 주는가
B. Object-knowledge 진단 $x_i^R$
\[x_i^R = \log p_{M_R}(o_i^+ \mid u_i) - \log p_{M_R}(o_i^- \mid u_i)\]- $o_i^+$: LAMA의 정답 object (canonical object)임.
- $o_i^-$: 같은 relation에 등장한 다른 object를 relation 내 빈도에 비례해 샘플링한 alternative object임. type은 같지만 정답과 다름.
- $u_i$: 두 object를 포함하지 않는 subject–relation prompt임. 예: “Mukul Roy is a citizen of [MASK]”.
- $M_R$: retrieval 학습이 끝난 모델의 representation 에 원래 backbone의 token-prediction head 를 붙인 것임. 이 단계에서는 검색을 하지 않음.
| Backbone 종류 | 모델 | 점수 방식 |
|---|---|---|
| MLM encoder | DPR, Spider, Spider-NQ, Spider-Trivia, Contriever (base), E5-large | [MASK] 위치의 MLM head 확률 |
| Decoder | Qwen3-Embedding-4B, Qwen3-Embedding-8B | prefix 다음 token 확률 |
- 두 object가 모두 single token인 예시만 사용함. 길이와 tokenization 효과를 피하기 위함임.
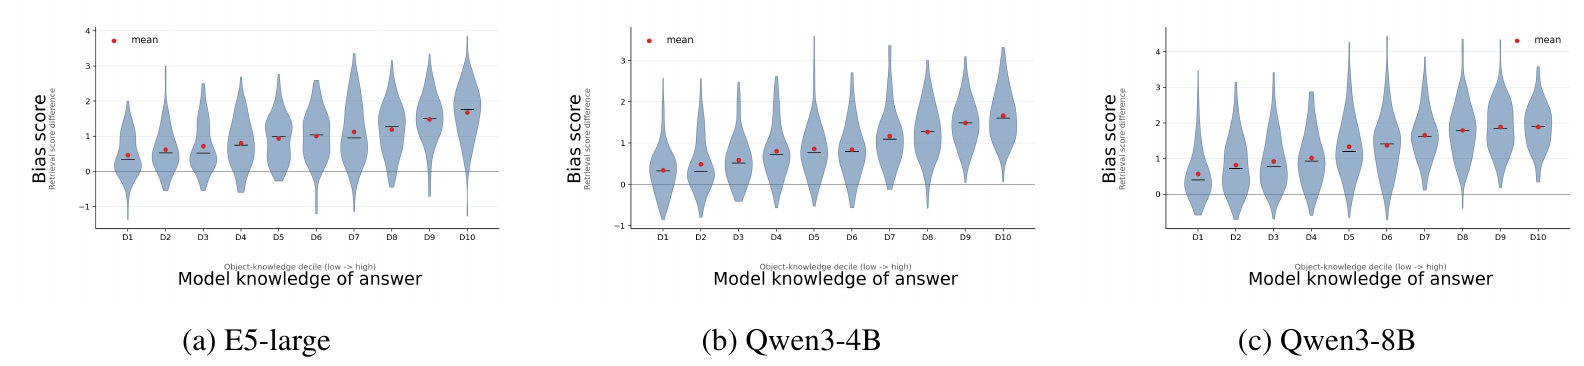
- $x_i^R > 0$ (모델이 정답 object를 더 선호)인 예시만 남기고 모델별로 1,000개를 무작위 샘플링함 (seed 13). 이후 $x$ 순으로 정렬해 10개 decile (각 100개)로 나눔.
| 모델 | 후보 pool | $x>0$ | $x>0$ 비율 | 선택 |
|---|---|---|---|---|
DPR | 20,000 | 15,929 | 79.6% | 1,000 |
Spider | 20,000 | 15,888 | 79.4% | 1,000 |
Spider-NQ | 20,000 | 15,918 | 79.6% | 1,000 |
Spider-Trivia | 20,000 | 15,684 | 78.4% | 1,000 |
Contriever | 20,000 | 11,734 | 58.7% | 1,000 |
E5-large | 20,000 | 14,477 | 72.4% | 1,000 |
Qwen3-4B | 34,039 | 27,632 | 81.2% | 1,000 |
Qwen3-8B | 34,039 | 28,489 | 83.7% | 1,000 |
- 비율 열은 논문 수치로 직접 계산한 값임.
C. 두 가지 passage 대조
| 설정 | Passage A | Passage B | 이상적 값 | Bias 신호 |
|---|---|---|---|---|
| Object-contrast | $c^+$: “Mukul Roy has citizenship in India.” | $c^-$: “Mukul Roy has citizenship in Bulgaria.” | 50% | A 선호율 > 50% |
| Relation–object conflict | $c^o$: “Mukul Roy died in India.” (정답 object, 틀린 relation) | $c^r$: “Mukul Roy has citizenship in Bulgaria.” (맞는 relation, alternative object) | 0% | A 선호율 > 0% |
- 점수 차이는 다음과 같이 정의함.
- $\tilde{s}_R$은 모델·설정별로 z-score 정규화한 retrieval 점수임. pair의 두 점수에 같은 affine 변환을 적용하므로 pair 내 선호는 바뀌지 않음.
- Conflict 설정의 대체 relation은 사람이 고른 template임. 예: country of citizenship → “was born in”, “died in”, “used to work in”, “maintains diplomatic relations with”.
- 보고 지표: 1,000개 전체의 Pearson $r(x, y)$, 선호율, 하위 5개 decile (Bottom)과 상위 5개 decile (Top)의 선호율.
D. 보조 분석
| 분석 | 목적 | 설정 |
|---|---|---|
| Relation 단위 상관 | relation 구성 차이로 생긴 착시인지 확인 | 예시 30개 이상인 relation–model 쌍 91개 |
| 고정 예시 크기 분석 | 모델별 예시 선택 효과 제거 | E5-large 기준 10개 bin × 20개 = 공통 200개, 13개 모델 |
| Original backbone 진단 | 편향이 사전학습에서 왔는지 확인 | retrieval 학습 전 backbone으로 $x$만 재계산, $y$는 그대로 |
| QAMPARI | 정답이 여럿인 실제 질문에서 확인 | answer-token rank ≤ 5를 known, > 20을 unknown으로 두고 top-100 검색 결과 비교 |
3. 실험
A. 주요 결과
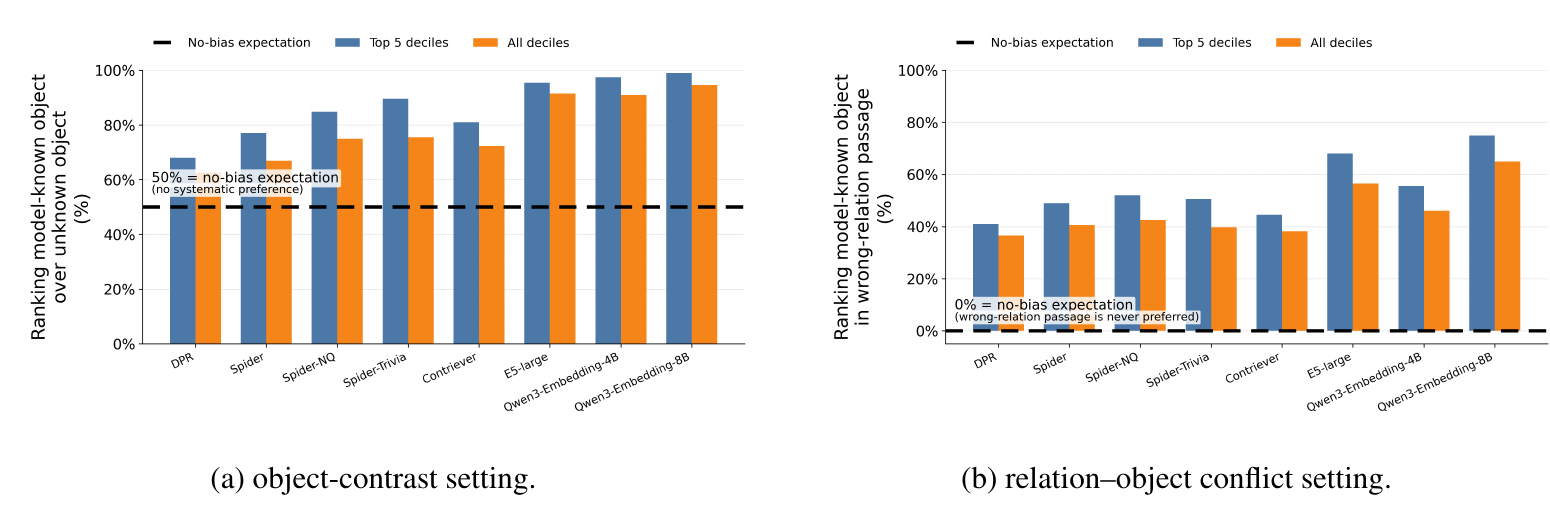
| 모델 | Obj $r$ | Obj 선호율 (전체 / Bottom / Top) | Conflict $r$ | Conflict 선호율 (전체 / Bottom / Top) |
|---|---|---|---|---|
DPR | 0.21 | 62.5 / 57.0 / 68.0% | 0.19 | 36.6 / 32.2 / 41.0% |
Spider | 0.29 | 66.9 / 56.8 / 77.0% | 0.22 | 40.6 / 32.2 / 49.0% |
Spider-NQ | 0.41 | 75.0 / 65.2 / 84.8% | 0.30 | 42.5 / 33.0 / 52.0% |
Spider-Trivia | 0.48 | 75.5 / 61.4 / 89.6% | 0.26 | 39.8 / 29.0 / 50.6% |
Contriever | 0.29 | 72.3 / 63.6 / 81.0% | 0.13 | 38.2 / 31.8 / 44.6% |
E5-large | 0.45 | 91.5 / 87.6 / 95.4% | 0.30 | 56.5 / 45.0 / 68.0% |
Qwen3-4B | 0.52 | 90.9 / 84.4 / 97.4% | 0.28 | 46.1 / 36.6 / 55.6% |
Qwen3-8B | 0.47 | 94.6 / 90.2 / 99.0% | 0.29 | 65.0 / 55.0 / 75.0% |
- 8개 retriever 모두 양의 상관을 보임: object-contrast $r$ = 0.21–0.52, conflict $r$ = 0.13–0.30.
- Object만 다를 때 모든 모델이 50%를 넘음: relation과 문장 형태가 같으므로 object identity만으로 점수가 달라진 것임.
E5-large와Qwen3계열은 90% 이상임. - 틀린 relation이 이기기도 함:
Qwen3-8B는 65.0%의 경우 “died in India”를 “has citizenship in Bulgaria”보다 위에 둠. 모든 모델에서 Top 선호율이 Bottom보다 높음. - Decile이 올라갈수록 점수 차 분포가 위로 이동함.
B. Relation 단위 견고성
- 예시 30개 이상인 relation–model 쌍 중 양의 상관은 object-contrast 84/91, conflict 75/91 임.
- Relation 내 median 상관은 object-contrast에서 8개 모두, conflict에서 7/8이 양수임.
- Relation별 conflict 선호율 편차가 매우 큼.
| Relation | 대체 relation 예 | DPR | Spider | Qwen3-8B |
|---|---|---|---|---|
| manufacturer | is owned by | 100.0% | 81.0% | 99.2% |
| instance of | is part of, consists of | 98.4% | 82.1% | 100.0% |
| native language | wrote in, worked in | 0.9% | 0.1% | 88.1% |
| diplomatic relations | shares border with | 1.1% | 0.0% | 0.0% |
C. 사전학습 기원과 모델 크기
| 모델 | Obj: retriever repr. | Obj: original backbone | Conflict: retriever repr. | Conflict: original backbone |
|---|---|---|---|---|
DPR | 0.21 | 0.22 | 0.19 | 0.19 |
Spider | 0.29 | 0.24 | 0.22 | 0.24 |
Spider-NQ | 0.41 | 0.38 | 0.30 | 0.31 |
Spider-Trivia | 0.48 | 0.46 | 0.26 | 0.30 |
Contriever | 0.29 | 0.13 | 0.13 | 0.20 |
E5-large | 0.45 | 0.60 | 0.30 | 0.25 |
Qwen3-4B | 0.52 | 0.46 | 0.28 | 0.25 |
Qwen3-8B | 0.47 | 0.46 | 0.29 | 0.28 |
- Retrieval 학습 전 backbone으로 계산해도 상관이 모두 양수임: 편향이 사전학습된 지식에서 온다는 해석을 뒷받침함.
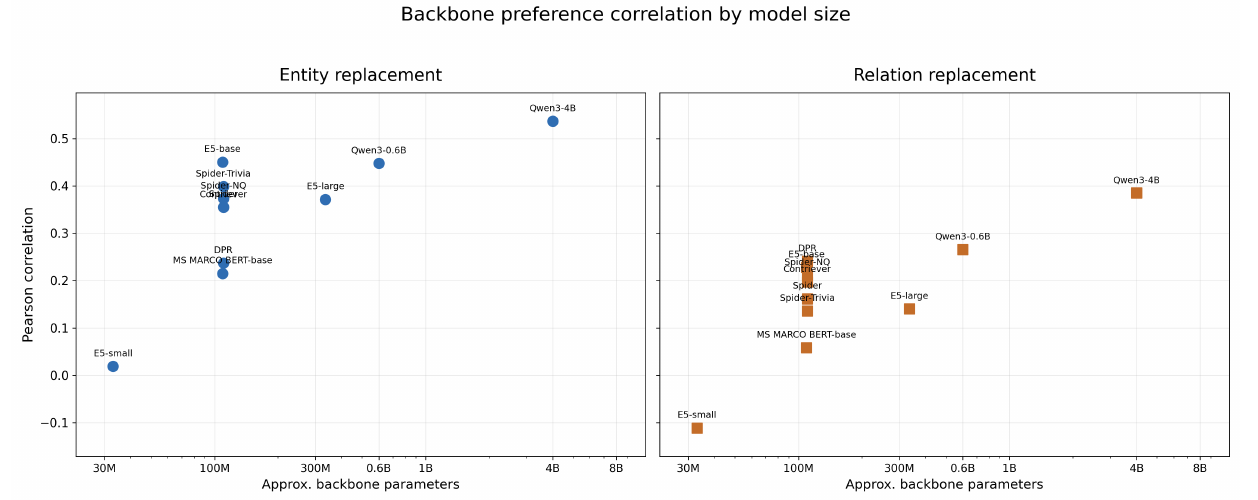
- 공통 200개 예시에서도 경향이 유지됨:
E5-small(~33M)은 거의 0이고,Qwen3-4B가 object-contrast 약 0.54, conflict 약 0.39로 가장 높음. 저자는 backbone이 커질수록 편향이 강해질 것으로 예상함.
D. QAMPARI: 정답이 여럿인 실제 질문
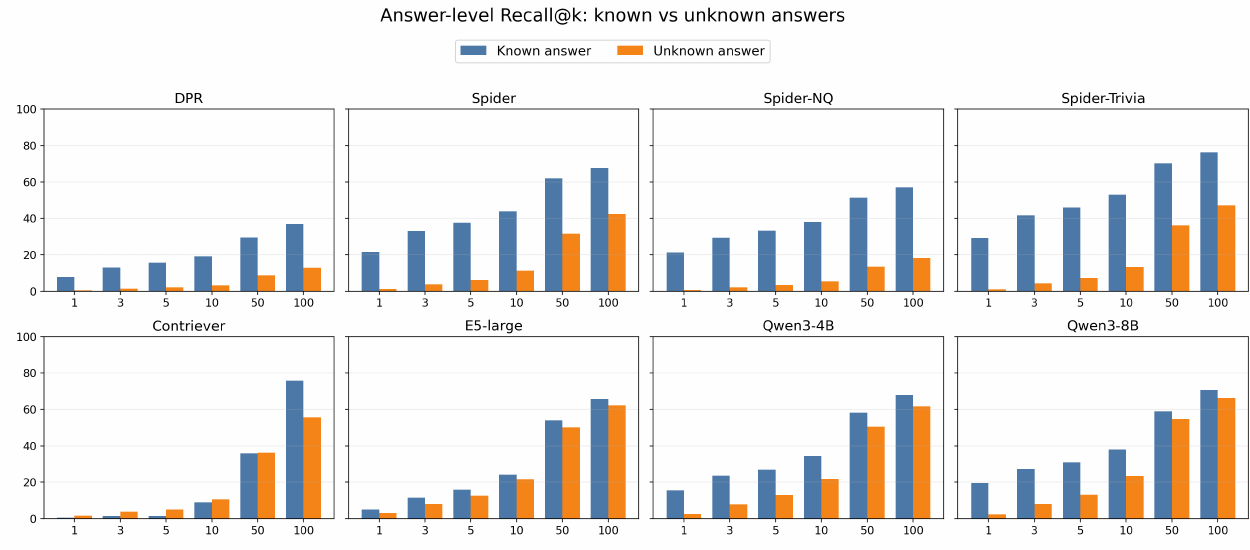
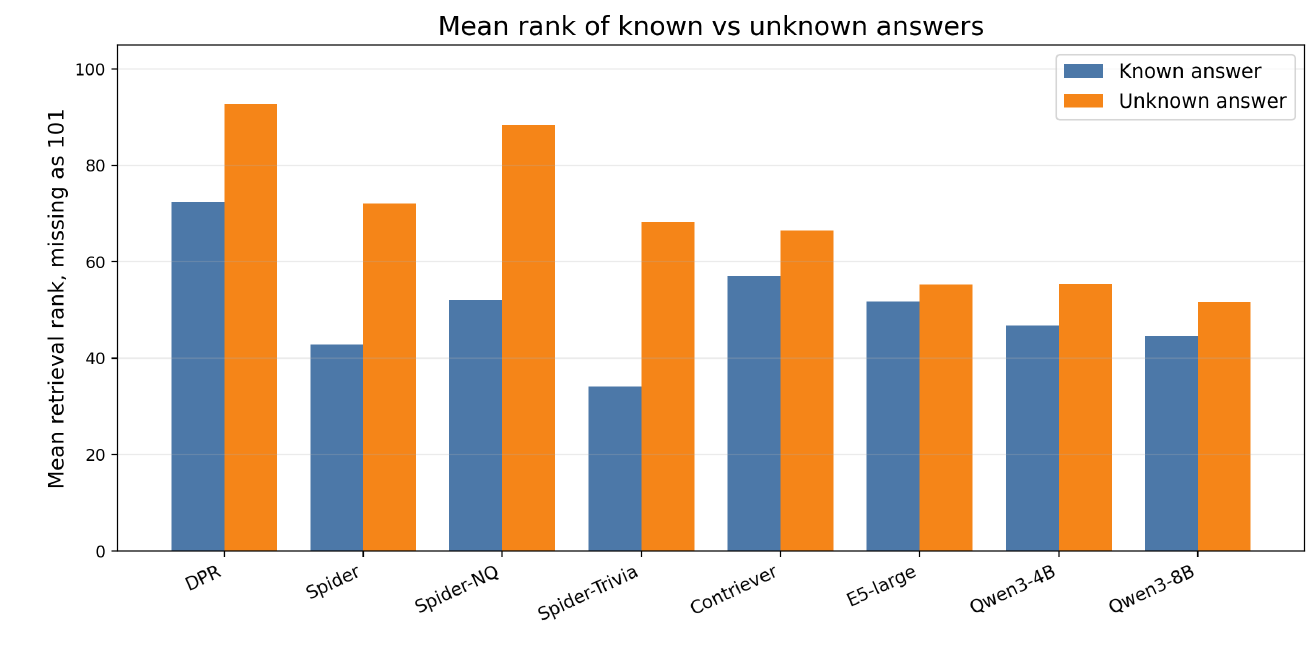
- 모든 retriever에서 known answer가 unknown answer보다 상위에 검색됨. 아래는 그래프를 판독한 근사값임 (top-100 밖은 101위로 계산).
| 모델 | Known 평균 순위 | Unknown 평균 순위 | 차이 |
|---|---|---|---|
DPR | ~72 | ~93 | ~21 |
Spider | ~43 | ~72 | ~29 |
Spider-NQ | ~52 | ~88 | ~36 |
Spider-Trivia | ~34 | ~68 | ~34 |
Contriever | ~57 | ~66 | ~9 |
E5-large | ~51 | ~55 | ~4 |
Qwen3-4B | ~47 | ~55 | ~8 |
Qwen3-8B | ~45 | ~51 | ~6 |
4. 결론
- Dense retriever는 질의의 subject와 relation만 보지 않고, backbone이 이미 아는 정답 object가 든 passage에 점수를 더 줌. 8개 retriever 모두에서 모델이 정답을 강하게 알수록 이 경향이 커짐.
- 이 편향은 object만 다른 경우뿐 아니라 relation이 틀린 passage에서도 나타나고, retrieval 학습 전 backbone에서도 같은 방향의 상관이 관찰됨.
- 정답이 여럿이거나 사실이 바뀌는 상황, 폐쇄 도메인에서 retrieval이 corpus 근거 대신 parametric knowledge 쪽으로 끌려갈 수 있다는 경고임. 완화 방법은 제안하지 않음.
한계
- “편향”과 “참 문장 선호”가 분리되지 않음: object-contrast의 $c^-$ (“Mukul Roy has citizenship in Bulgaria”)는 대부분 거짓 문장이라, $c^+$를 고르는 것은 QA retriever의 정상 동작이기도 함. 이를 가를 수 있는 것은 모델이 틀린 답을 더 믿는 $x<0$ 예시 (
Contriever41%,E5-large28%, 나머지 16–22%)인데 분석에서 제외했음. 여기서 retriever가 틀린 쪽 passage를 고른다면 모델의 믿음을 따라 검색한다 는 가장 직접적인 증거가 되었을 것임. $x>0$ 선택과 정렬은 흔한 object가 위로 오게 만들어 entity 인기도와도 혼동됨. - 실제 데이터 결과가 통제 실험과 반대 방향임: QAMPARI에서 통제 실험 선호율이 가장 높았던
E5-large,Qwen3의 known–unknown 평균 순위 차이는 약 4–8로 가장 작고,DPR·Spider계열은 약 21–36으로 큼. “backbone이 클수록 편향이 강해진다”는 주장과 맞지 않음. known answer는 corpus에 근거 passage 자체가 많을 수 있는데 이를 통제하지 않았고, 개입 실험 없이 상관만 보여 실제 RAG 성능에 미치는 영향도 알 수 없음.
This post is licensed under CC BY 4.0 by the author.